С чего начинается проектирование высоконагруженных систем: нагрузка, риски и измеримые пределы
Чтобы создавать высоконагруженные системы, нужны инженерные решения, основанные на реальной нагрузке и её влиянии на бизнес. При разработке масштабируемых систем важно понимать, какие ресурсы закончатся первыми, как сбои повлияют на пользователей и сколько будет стоить дополнительная мощность. Подходящая архитектура решает эти задачи без усложнений, с которыми команда не сможет справиться при эксплуатации.
Медленный запрос к базе данных может задержать обработку заказов. Перегруженная интеграция может остановить регистрацию клиентов. Эти проблемы требуют разных решений, даже если на панелях мониторинга видна одинаковая частота запросов.
В Webdelo мы рассматриваем инженерные задачи на всём пути от архитектуры до долгосрочной поддержки. Компания основана в 2006 году. Мы создаём B2B-платформы и сложное ПО, включая ERP/CRM и высоконагруженные сервисы. Наша разработка сайтов связывает требования к продукту с реализацией и эксплуатацией.
В этом руководстве мы объясняем, как подходим к решениям при разработке высоконагруженных систем. Разбираем поиск узких мест, выбор архитектуры и данные, которые нужны перед вложениями в масштабирование. Примеры приведены для иллюстрации. О нашей экспертизе мы говорим только на основе документально подтверждённых фактов о компании и опубликованных инженерных материалов.
Когда нагрузка становится архитектурной проблемой?
Система сталкивается с высокой нагрузкой, когда спрос на её ресурсы приближается к практическим пределам и угрожает требуемой производительности или корректности работы. Универсального порога запросов в секунду нет. Значимый предел зависит от того, какую работу выполняет каждый запрос и какой уровень обслуживания нужен бизнесу.
Почему фиксированные пороги RPS вводят в заблуждение
Количество запросов в секунду, или RPS, измеряет объём трафика. Оно не описывает сложность транзакций. В условном примере API оформления заказа с нагрузкой 200 RPS может предъявлять более строгие требования к согласованности данных и задержке, чем статический сайт, который обслуживает 20 000 RPS через сеть доставки контента.
Число одновременных соединений отражает другой аспект нагрузки. Тысячи преимущественно простаивающих соединений могут почти не загружать процессор, но при этом исчерпать лимит соединений или память. При планировании мощности нужно учитывать и скорость поступления запросов, и ресурсы, занятые текущей работой.
Платформы с интенсивной обработкой данных тратят значительную часть ресурсов на хранение, чтение или согласование данных. Платформы с интенсивными вычислениями тратят больше ресурсов на расчёты. Crm система может столкнуться с высокой нагрузкой на данные из-за отчётности и синхронизации задолго до того, как число пользователей станет необычно большим.
Метрики, которые показывают реальную нагрузку
Мы рекомендуем описать профиль нагрузки до выбора инфраструктуры. Он должен отражать обычную нагрузку, ожидаемые пики и соотношение операций, из которых складываются эти показатели.
- Пропускная способность: входящий RPS и число успешно завершённых операций с разбивкой по пользовательским сценариям.
- Одновременная работа: активные запросы, сессии, соединения и фоновые задания.
- Задержка: время отклика p95 и p99 для важных операций.
- Ошибки: тайм-ауты, отклонённые запросы и неуспешные бизнес-транзакции.
- Насыщение ресурсов: нагрузка на процессор, память, диск, пулы соединений и обработчики.
- Рост данных: объём хранимых данных, размер активно используемого набора и изменение стоимости запросов.
- Отставание очереди: объём накопившихся задач и время, прошедшее с поступления незавершённой работы.
Влияние на бизнес определяет, какие пределы важнее всего. Задержка аналитического отчёта может быть допустима. Задержка резервирования товара может привести к продаже сверх доступного остатка. Для обоих случаев нужны явные требования, а не одно среднее время отклика на всю платформу.
Что первым перестаёт справляться при росте трафика?
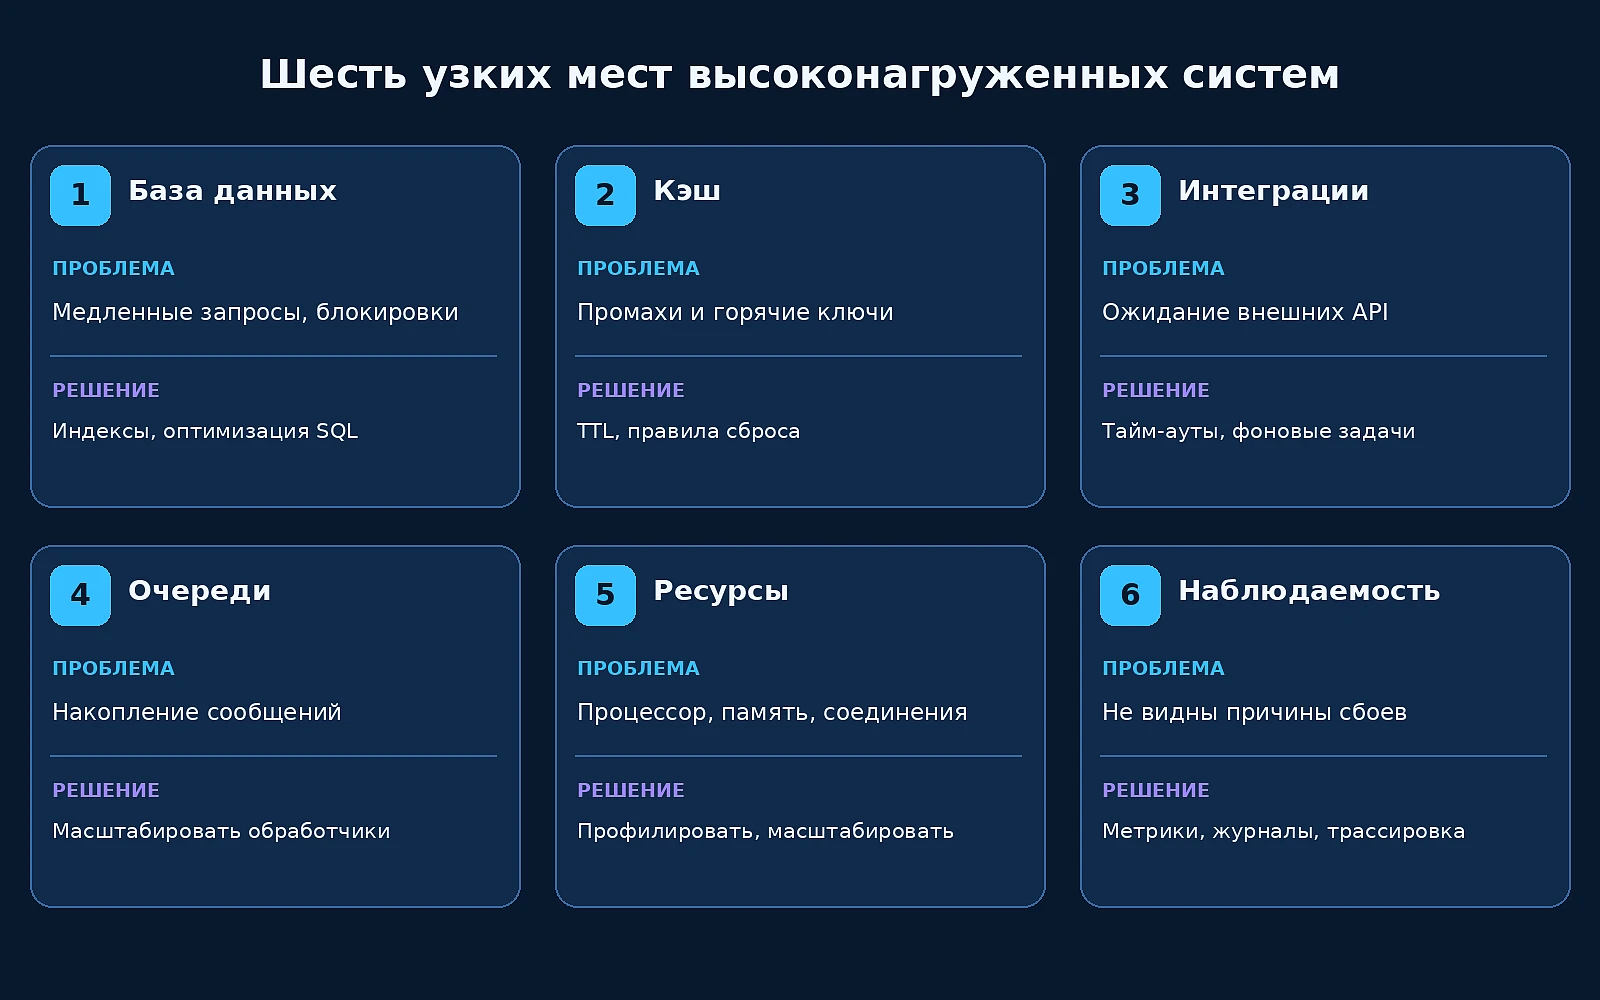
В системах с большим числом транзакций первым узким местом часто становится база данных. Сбои кэша, синхронные интеграции и растущие очереди тоже могут исчерпать доступную мощность ещё до того, как заметно загрузится процессор приложения. Диагностика начинается с поиска мест, где запросы ждут, а не с предположения, что любое замедление требует дополнительных серверов.
Ожидание в базе данных и нагрузка на соединения
Отсутствующий индекс увеличивает объём работы для каждого запроса. Конкуренция за блокировки заставляет транзакции ждать друг друга. Шаблон запросов N+1 превращает один запрос приложения во множество обращений к базе данных.
Пулы соединений создают ещё одно ограничение. Когда все соединения заняты, новые запросы ждут свободного места. Добавление экземпляров приложения может усугубить проблему, потому что каждый экземпляр способен открыть ещё один пул соединений с той же базой данных.
Промахи кэша и медленные зависимости
Лавина запросов при обновлении кэша возникает, когда множество запросов пытаются заново вычислить одно и то же значение с истёкшим сроком хранения. Возникающая нагрузка на базу данных может перегрузить систему, которая нормально работала с прогретым кэшем.
Синхронные интеграции задерживают выполнение запроса до ответа другого сервиса. В интернет-магазине медленный сервис расчёта доставки может занять обработчики оформления заказа, даже если собственная база данных магазина работает нормально. Начать следует с ограниченного тайм-аута и согласованного резервного сценария либо сценария отказа.
Накопленные задачи, пределы ресурсов и слепые зоны
Очередь сглаживает временные всплески, но не может бесконечно компенсировать недостаточную скорость обработки. Растущее число необработанных задач задерживает бизнес-результаты и со временем угрожает нарушить ограничения по сроку хранения или объёму хранилища.
Нехватка памяти и заполнение дисков могут возникать и вне основного пути обработки запросов. Если данные телеметрии не связаны между собой, команда может масштабировать серверы приложений, хотя реальным ограничением остаётся общая база данных или внешний API.
Из чего состоит масштабируемая архитектура высоконагруженных систем
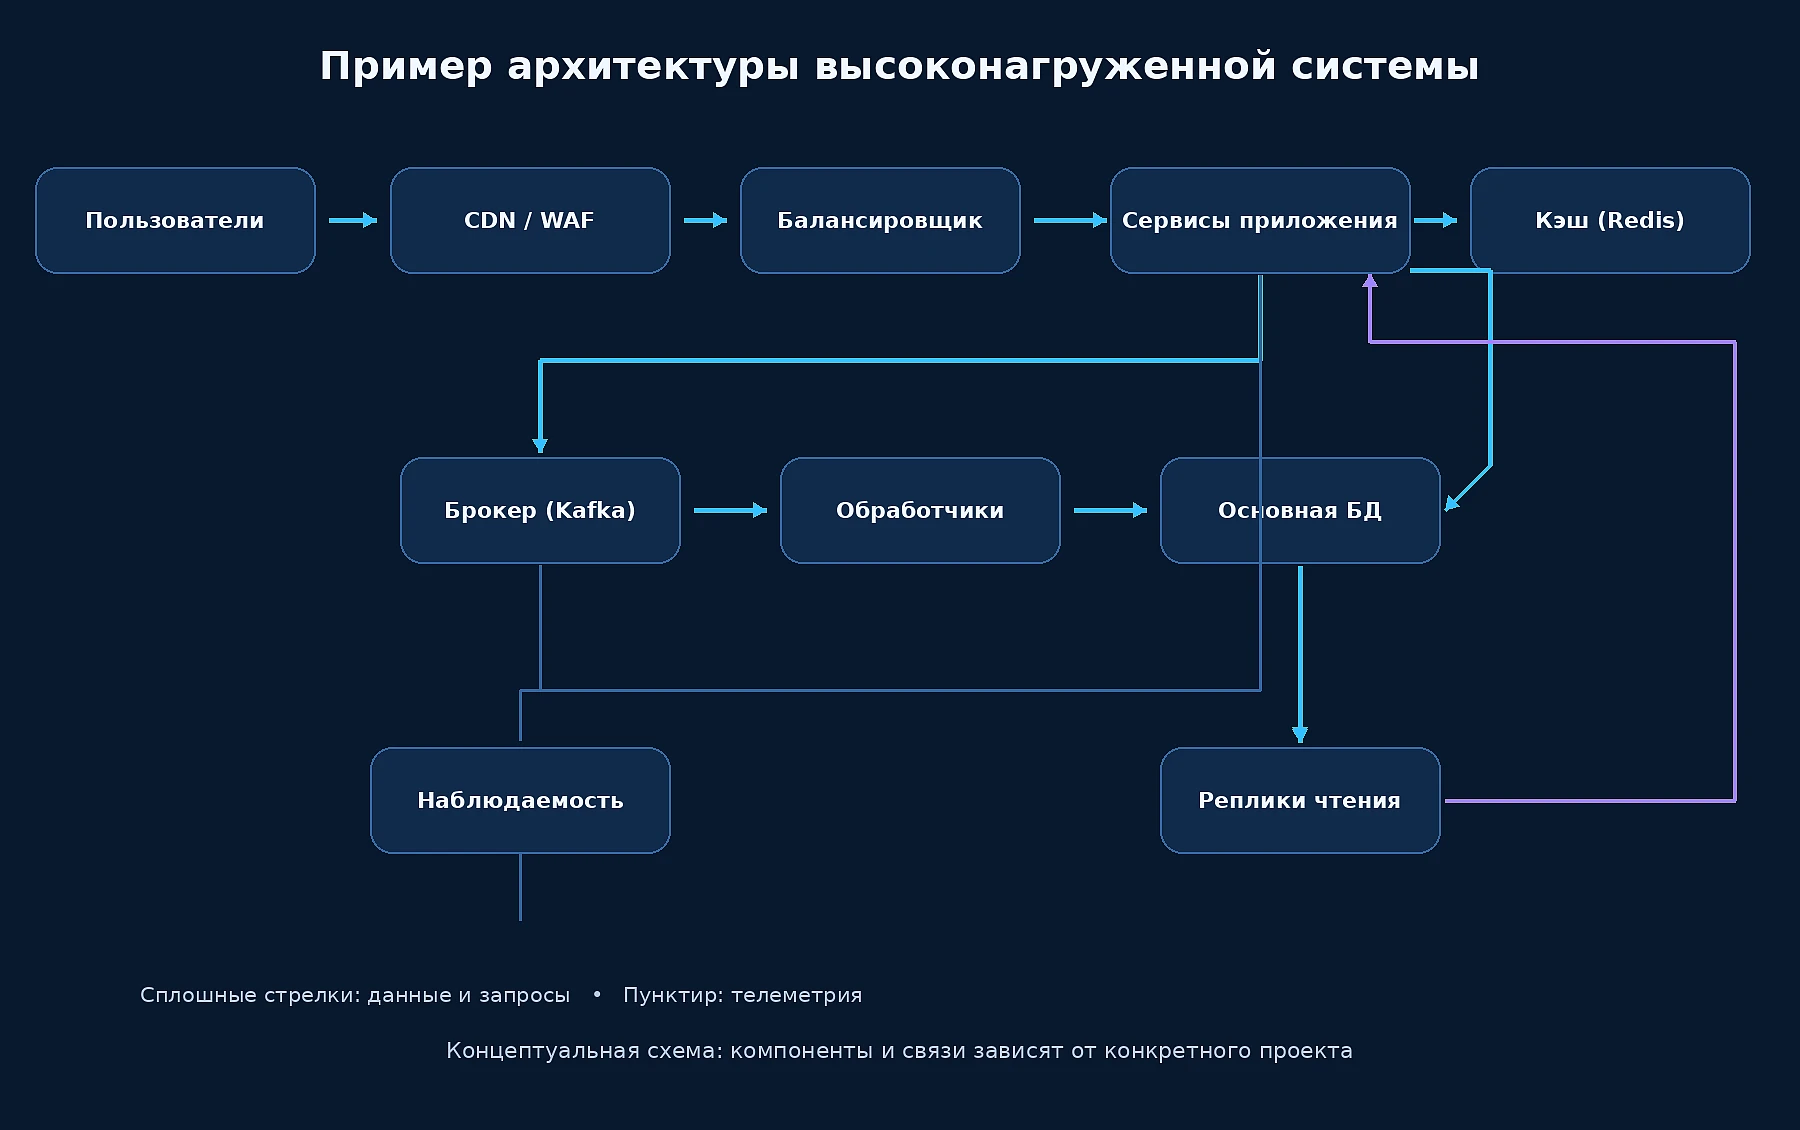
Масштабируемая программная архитектура обычно объединяет управление трафиком, обработку в приложении, хранение данных и телеметрию. CDN/WAF, балансировщики нагрузки, сервисы без состояния, кэши и брокеры сообщений служат типовыми строительными блоками. Каждый из них должен решать конкретную проблему производительности или надёжности.
Курс Северо-Западного университета США по масштабируемой архитектуре описывает похожий набор компонентов крупных интернет-сервисов. Привычная модель "фронтенд, бэкенд и база данных" остаётся полезной отправной точкой. У дополнительных слоёв должны быть чёткие обязанности.
Периферийный слой, балансировка и сервисы без состояния
Сеть доставки контента, или CDN, отдаёт кэшируемый контент ближе к пользователям. Межсетевой экран веб-приложений, или WAF, фильтрует запросы по правилам безопасности. Ни один из этих компонентов не отменяет необходимость авторизации и защиты от злоупотреблений на уровне приложения.
Балансировщик нагрузки распределяет входящие запросы между работоспособными экземплярами. Экземпляры приложения без состояния хранят долговременное состояние сессий вне памяти локального процесса. Поэтому следующий запрос может обработать другой экземпляр, не зависящий от исходного сервера.
На корпоративном сайте значительная часть публичного контента может хорошо поддаваться кэшированию. Для страниц личного кабинета нужны другие правила. Неверный ключ кэша может раскрыть персонализированный контент, поэтому политику кэширования нужно проверять при анализе безопасности.
Данные, обработка и телеметрия
PostgreSQL может выполнять транзакционную запись в основную базу данных. Реплики для чтения могут обслуживать подходящие запросы на чтение. Redis может хранить часто используемые результаты, а Kafka или RabbitMQ могут передавать работу фоновым обработчикам.
Метрики, логи и трассировки связывают эти слои при эксплуатации. На карте компонентов также нужно указать ответственных и поведение при сбоях. Для каждой зависимости опишите, что происходит, когда она замедляется, становится недоступной или возвращает несогласованные данные.
Каждый дополнительный компонент требует работы по эксплуатации. Прежде чем его добавлять, определите, кто будет устанавливать обновления, следить за его состоянием и восстанавливать данные. Если схема не отражает эти обязанности, она занижает стоимость архитектуры.
Монолит, модульный монолит или микросервисная архитектура?
Самая веская причина выбрать микросервисную архитектуру - потребность в независимой ответственности за сервисы, их развёртывании или масштабировании. Модульный монолит сохраняет единое развёртывание, но задаёт чёткие границы предметных областей. Мы предпочитаем выбирать между ними на основе измеренных ограничений и возможностей команды.
| Критерий | Монолит | Модульный монолит | Микросервисы |
|---|---|---|---|
| Развёртывание | Единый выпуск приложения | Единый выпуск с явными внутренними границами | Отдельные выпуски сервисов |
| Независимое масштабирование | Обычно масштабируется целиком | Обычно масштабируется целиком до выделения модулей | Сервисы могут масштабироваться отдельно |
| Ответственность за данные | Часто общая для всего приложения | Определена для каждого модуля, даже в одной базе данных | Определена для каждого сервиса, доступ контролируется |
| Затраты на эксплуатацию | Относительно небольшие | Немного инфраструктуры, но нужен контроль границ | Более высокие требования к сети, развёртыванию и телеметрии |
| Подходящая команда | Одна согласованно работающая команда | Одна команда или несколько тесно взаимодействующих команд | Команды, способные отвечать за сервисы вплоть до эксплуатации |
| Отладка | В основном внутри одного процесса | Внутри одного процесса через явные интерфейсы | Через сетевые и асинхронные границы |
| Стоимость изменений | Растёт с внутренней связанностью | Остаётся под контролем, пока соблюдаются границы модулей | Низкая для изолированных изменений, выше для межсервисных |
Почему мы предпочитаем сначала выделить чёткие модули
Мы рекомендуем определить границы предметных областей до того, как распределять их между сервисами. Модуль заказов должен предоставлять продуманный набор операций, а не позволять постороннему коду напрямую обновлять свои таблицы. Это уменьшает связанность и упрощает последующее выделение модуля.
Модульный монолит тоже требует дисциплины. Общие таблицы, циклические зависимости и неограниченные внутренние вызовы могут свести его преимущества на нет. Проверка границ и ревью кода важны не меньше структуры папок.
Выделение сервиса становится привлекательнее, когда у модуля появляется особый профиль нагрузки или собственный ритм выпусков. При принятии решения нужно учитывать затраты на дежурства и поддержание согласованности между сервисами. Само по себе разделение кода не даёт независимости при эксплуатации.
Событийный подход при разных моделях развёртывания
Событийное проектирование - это способ взаимодействия, а не конкурирующая модель развёртывания. Монолит может публиковать события для фоновых обработчиков. Микросервисы могут использовать синхронные API, асинхронные события или оба подхода.
Уведомления и формирование отчётов часто допускают отложенное завершение. Подтверждение наличия товара может требовать немедленного результата. Выбирайте способ взаимодействия для каждой бизнес-операции и определяйте, что видит пользователь, пока асинхронная работа ещё не завершена.
Базы данных, кэширование в Redis и надёжный обмен сообщениями
Слой данных задаёт практические пределы пропускной способности и корректности работы. Репликация PostgreSQL может разгрузить чтение, кэширование в Redis позволяет избежать повторной работы, а обмен сообщениями разделяет этапы обработки. Но эти механизмы также создают риски устаревших данных, отложенного завершения и повторной доставки.
Мы рекомендуем изучить планы запросов и границы транзакций, прежде чем добавлять инфраструктуру. Опубликованное техническое руководство Webdelo по пакетной вставке в PostgreSQL на Go даёт конкретный пример работы с записью данных. Оно служит основой для технического обсуждения, но не подразумевает неопубликованных клиентских результатов или сравнительных тестов.
Основной узел PostgreSQL и реплики для чтения
Реплики для чтения могут отставать от основного узла. Пользователь, который обновил данные учётной записи и сразу перезагрузил страницу, может увидеть старые данные, если чтение попало на отстающую реплику. Направляйте запросы, чувствительные к согласованности, на основной узел или используйте явно выбранный механизм согласованности.
Реплики не устраняют узкое место записи на основном узле. Пулы соединений, эффективные индексы и более короткие транзакции могут дать больший запас производительности. Секционирование помогает некоторым нагрузкам, но только если выбранный ключ секционирования полезен для характерных запросов и операций обслуживания.
Пакетная запись сокращает повторяющиеся накладные расходы. Но слишком большие пакеты могут дольше удерживать блокировки и увеличивать объём работы при восстановлении после сбоя. Подбирайте размер пакета в тестах с характерными записями и границами транзакций.
Кэширование в Redis с контролируемым поведением при сбоях
Для кэша нужны согласованные требования к свежести данных. Определите, какие данные могут устаревать, на какой срок и что делает их недействительными. Для финансовых остатков и описаний товаров редко подходит одна и та же политика.
Случайный разброс сроков хранения снижает вероятность одновременного обновления множества значений. Объединение одинаковых запросов позволяет одному обработчику восстановить отсутствующее значение, а остальным использовать его результат. Оба приёма уменьшают нагрузку при обновлении кэша.
При недоступности кэша последствия должны оставаться ограниченными. Неограниченное переключение на базу данных может превратить проблему кэша в отказ всей платформы. Ограничение частоты запросов, выдача устаревших данных там, где это допустимо, и контролируемое отклонение запросов помогают защитить важнейшие транзакции.
Kafka, RabbitMQ и идемпотентность
Kafka часто подходит для потоков событий с хранением и повторным воспроизведением. RabbitMQ часто полезен для маршрутизируемых задач и рабочих очередей. Оцените требования к порядку, хранению и поведению потребителей, прежде чем выбирать очереди Kafka только потому, что трафик растёт.
Во многих практических конфигурациях доставки сообщения могут приходить повторно. Идемпотентность означает, что повторная обработка той же операции не создаёт дополнительного бизнес-эффекта. Например, потребитель может сохранять уникальный идентификатор операции в той же транзакции базы данных, что и защищаемое обновление.
В библиотеке инженерных материалов AWS рассматриваются повторные попытки и устойчивые распределённые системы. Практический вывод: безопасность повторов нужно проектировать вокруг бизнес-эффектов. Само подтверждение сообщения не доказывает, что платёж или заказ был обработан только один раз.
Если обновление базы данных должно также публиковать событие, рассмотрите шаблон транзакционного исходящего журнала, или transactional outbox. Приложение сохраняет изменение и запись исходящего события в одной транзакции. Отдельный процесс публикует событие, а потребители остаются готовыми к дубликатам.
Горизонтальное масштабирование и DevOps требуют учёта общих лимитов
Горизонтальное масштабирование добавляет экземпляры для обработки, а вертикальное даёт существующему экземпляру больше ресурсов. Оба инструмента применимы. Масштабирование работает только тогда, когда общие зависимости и процессы развёртывания способны поддержать дополнительную мощность.
Экземпляры приложения могут масштабироваться независимо, но они всё равно конкурируют за соединения с базой данных и квоты внешних API. Задайте общий бюджет соединений до увеличения числа реплик приложения. Резервируйте мощность не только для обычного трафика, но и для обслуживания и восстановления.
В документации Kubernetes описаны механизмы автоматического масштабирования рабочих нагрузок. Kubernetes не устраняет задержки запуска и ограничения зависимостей. Выбирайте сигналы масштабирования, которые отражают характер работы, например возраст задач в очереди для фоновой обработки.
Наше направление DevOps и инфраструктура Webdelo входит в разработку полного цикла. Чтобы архитектура оставалась управляемой по мере роста продукта, нужны автоматизация развёртывания и понимание того, что происходит в рабочей среде.
- Автоматизируйте выпуски: собирайте и тестируйте воспроизводимые артефакты вместо ручного изменения серверов.
- Ограничивайте влияние нового выпуска: развёртывайте его постепенно и сравнивайте эксплуатационные показатели.
- Сохраняйте возможность отката: где это требуется, обеспечивайте совместимость изменений базы данных с предыдущей версией приложения.
- Безопасно завершайте работу: прекращайте приём новых запросов до остановки экземпляра.
- Проверяйте работу при сниженной мощности: тестируйте поведение при недоступности экземпляра или отдельного домена отказа.
Публичный трафик включает и легитимных поисковых роботов. Согласуйте кэширование и доступ роботов с работами по сео продвижению сайтов, чтобы важные страницы оставались доступными без постоянного запуска ресурсоёмких операций бэкенда.
Для продвижения в Ai, то есть повышения видимости в генеративном поиске, полезный публичный контент тоже должен оставаться доступным для получения. Осознанно задавайте правила для роботов и ограничения ресурсов. Не считайте, что все автоматические запросы одинаково полезны или опасны.
Нагрузочное тестирование и наблюдаемость показывают предел производительности
Нагрузочное тестирование измеряет поведение системы при контролируемой нагрузке. Наблюдаемость, или observability, помогает объяснить это поведение через телеметрию. Анализируйте RPS, высокие перцентили задержки, ошибки и насыщение ресурсов вместе, чтобы определить диапазон работы, в котором система ещё отвечает требованиям пользователей.
В документации Grafana k6 описаны сценарии нагрузки и пороговые критерии прохождения тестов. Полезный сценарий воспроизводит реальные операции, включая аутентификацию и реалистичный доступ к данным. Повторные запросы к одной кэшируемой конечной точке мало говорят о пропускной способности транзакционных операций.
Прогнозы трафика должны учитывать запуск продуктов и кампании в рамках интернет маркетинга. Кампания, которая направляет пользователей в один ресурсоёмкий сценарий, может создать иное узкое место, чем тот же трафик, распределённый по всей платформе.
Как читать задержки p95 и p99
Задержка p95 - это время отклика, за которое завершаются 95 % измеренных запросов или больше. Задержка p99 описывает соответствующую границу для 99 %. Эти перцентили относятся к запросам, а не обязательно к уникальным пользователям. Они показывают задержки, которые могут скрываться за средними значениями.
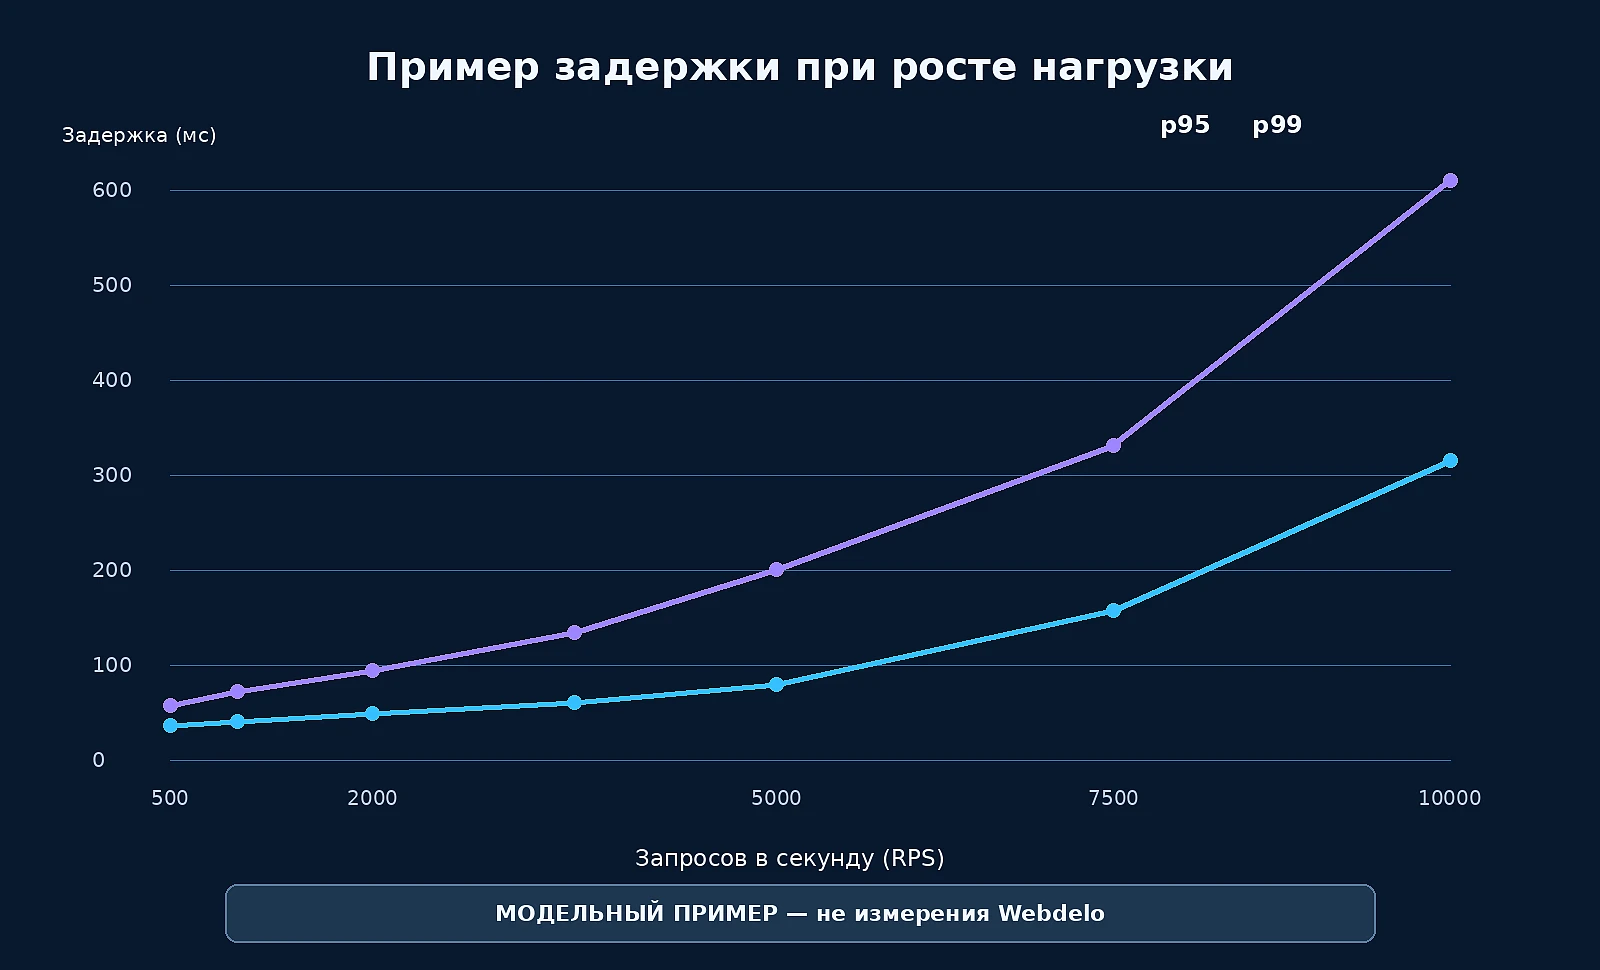
Резкий рост p99 может указывать на увеличение очередей или конкуренцию за ресурсы. Это предупреждение, а не универсальная формула расчёта мощности. Рабочий предел - наибольшая проверенная нагрузка, при которой выполняются согласованные критерии и остаётся достаточный запас на ожидаемые колебания и сбои.
При анализе задержки разделяйте успешные и неуспешные запросы. Быстрые ответы с ошибками могут улучшить общую статистику задержек, пока полезная пропускная способность резко падает. Также проверяйте, что генератор нагрузки действительно обеспечил заданную частоту поступления запросов.
Как составить репрезентативную программу тестирования
- Базовые тесты: определяют поведение при ожидаемой обычной нагрузке.
- Стресс-тесты: повышают нагрузку, чтобы найти пределы и оценить поведение при перегрузке.
- Тесты резких всплесков: проверяют реакцию на внезапные изменения трафика и работу масштабирования.
- Длительные тесты: поддерживают нагрузку, чтобы выявить утечки, накопление необработанных задач и рост хранилища.
Используйте характерные объёмы данных и способы доступа. База с небольшим тестовым набором может дать обманчивые планы запросов и показатели попадания в кэш. Включайте ресурсоёмкие сценарии, а не моделируйте только самую популярную конечную точку.
Пропускная способность бэкенда отличается и от воспринимаемой скорости страницы. При работе над дизайном сайта нужно учитывать размер загружаемых ресурсов и порядок загрузки наряду с серверными тестами инженерной команды. Быстрый API не компенсирует чрезмерную нагрузку на браузер.
Как связать метрики, логи и трассировки
OpenTelemetry предоставляет независимые от поставщика инструменты сбора метрик, логов и трассировок. Метрики показывают тенденции, логи фиксируют события, а трассировки отслеживают работу при переходе между компонентами.
Добавляйте телеметрию в важные бизнес-сценарии и передавайте контекст корреляции через асинхронную обработку. Записывайте версии развёрнутого приложения, чтобы связывать ухудшения с изменениями. Не допускайте попадания чувствительных клиентских данных в телеметрию. Контролируйте атрибуты с большим числом уникальных значений, которые могут сделать мониторинг дорогим.
Отказоустойчивость и высокая доступность требуют проверенного восстановления
Отказоустойчивые системы сохраняют заданное поведение при определённых отказах. Устойчивость включает способность выдерживать нарушения работы и восстанавливаться, иногда за счёт контролируемого сокращения функциональности. Высокая доступность зависит от резервирования, изоляции отказов и процедур восстановления, соответствующих явным целевым показателям сервиса.
Определите, какие отказы нужно выдерживать
Для отказоустойчивости всегда нужна модель отказов. Способность пережить отказ одного экземпляра приложения не доказывает устойчивость к сбою целого региона. Определите, с какими отказами должна справляться архитектура и что пользователи должны видеть в каждом случае.
Блок рекомендаций может показывать кэшированный контент при сбое зависимости. Баланс счёта должен сохранять требуемую корректность. Поэтому контролируемое сокращение функциональности требует продуктового решения, а не только инфраструктурного механизма.
SLO, SLA и бюджет ошибок
Целевой уровень обслуживания, или SLO, задаёт измеримую цель по производительности или надёжности. Соглашение об уровне обслуживания, или SLA, закрепляет договорные обязательства и определённые последствия их нарушения. Ни то ни другое нельзя выбирать в отрыве от возможностей измерения и восстановления.
В практическом руководстве Google SRE объясняются SLO и бюджеты ошибок. Бюджет ошибок - допустимый объём сбоев за период измерения целевого показателя. Он даёт команде основу для решения, когда работа над надёжностью должна стать важнее новых изменений.
Определяйте цели вокруг завершённых пользовательских сценариев. Успешный HTTP-статус в ответе сервера не доказывает, что заказ принят корректно. Измерения должны различать исправность инфраструктуры и успешный бизнес-результат.
Тайм-ауты, повторные попытки и автоматические выключатели
Исходящим вызовам нужны ограниченные тайм-ауты в рамках общего бюджета времени запроса. Повторным попыткам нужны лимиты и нарастающая задержка между попытками. Случайный разброс задержек не даёт множеству клиентов повторять запросы одновременно.
Автоматический выключатель, или circuit breaker, временно прекращает вызовы к сбоящей зависимости. Ограничение параллелизма создаёт ещё одну границу: оно задаёт, сколько одновременно выполняемой работы может занимать эта зависимость. Вместе эти меры помогают сдерживать каскадные отказы.
Отрабатывайте восстановление из резервных копий и измеряйте результат. Определите допустимую потерю данных и время восстановления до инцидента. Успешное задание резервного копирования не доказывает, что приложение удастся восстановить с согласованными данными и действующими учётными данными.
Разработка высоконагруженных систем: как Webdelo принимает инженерные решения
Наш подход начинается с критичных для бизнеса сценариев и измеренных ограничений. Мы рекомендуем самую простую архитектуру, которая обеспечивает требуемые рабочие показатели. Публичные инженерные материалы подтверждают нашу техническую компетентность без выдуманных клиентских историй и недоступных показателей производительности.
Webdelo основана в 2006 году, инженерная команда компании представлена в Восточной Европе. Мы разрабатываем B2B-платформы, ERP/CRM-системы, инструменты для финансовых технологий и трейдинга. В наш объём работ также входят IoT и высоконагруженные сервисы: от исследования задачи и архитектуры до DevOps и поддержки.
В инженерное руководство входит основатель и CTO Webdelo Андрей Попов. Его публичный профиль содержит сведения о техническом руководстве. Кроме того, Webdelo является резидентом Moldova IT Park с 2021 года. Это факт о компании, а не сертификат производительности.
Что показывают наши публичные инженерные материалы
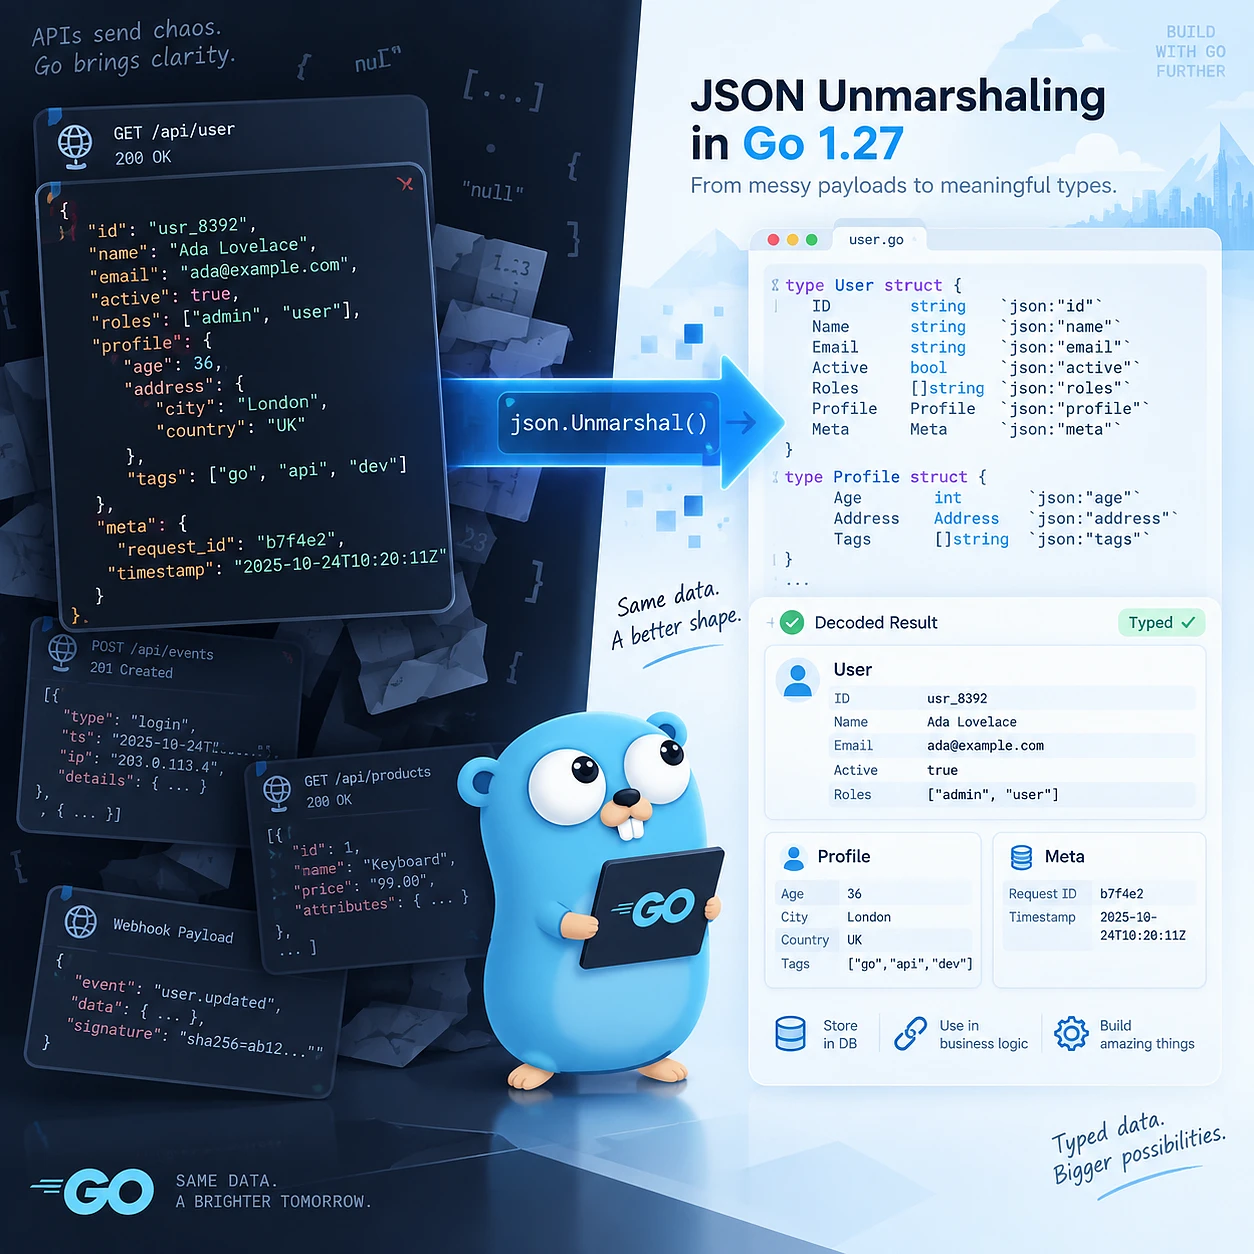
Руководство по пакетной вставке в PostgreSQL на Go описывает работу на уровне доступа к данным. Опубликованные материалы об обработке JSON в Go и нагрузочном тестировании электронной коммерции рассматривают поведение кода и проектирование тестов. Это конкретные технические темы, которые влияют на пропускную способность платформы.
Сама публикация не устанавливает показатель мощности для другого приложения. Оборудование, наборы данных и семантика транзакций меняют результат. Поэтому мы рассматриваем эти материалы как подтверждение работы с инженерными темами, а не как результаты тестов, которые можно переносить на другие системы.
Наш подход к архитектурному аудиту
Архитектурный аудит должен давать решения, которые инженерная команда сможет реализовать. Предлагаемый нами подход связывает бизнес-требования с проверяемыми данными, а затем с планом действий по приоритетам.
- Опишите критичные сценарии. Найдите операции, которые приносят выручку или защищают доверие клиентов. Зафиксируйте требования к задержке, корректности и восстановлению.
- Определите нагрузку. Опишите текущую нагрузку, ожидаемый рост и характеристики данных. Отделите наблюдаемые факты от допущений для планирования.
- Найдите ограничивающий ресурс. С помощью телеметрии и контролируемых тестов определите места ожидания, конкуренции за ресурсы и неуспешной работы. Учитывайте квоты зависимостей и эксплуатационные ограничения.
- Сравните варианты изменений. Оцените локальные улучшения до выделения сервисов или переписывания системы. Опишите трудозатраты на реализацию, стоимость эксплуатации и риски миграции.
- Задайте критерии подтверждения результата. Определите, как команда докажет улучшение и обнаружит ухудшение. Назначьте ответственных за тестирование и последующую проверку в рабочей среде.
Результаты работы должны включать карту зависимостей и список узких мест по приоритетам. Для вариантов архитектуры нужны явные допущения и компромиссы. Описание мощности должно указывать проверенную нагрузку и среду, а не сводиться к одному числу RPS без контекста.
Когда мы оспариваем типовые рекомендации
Мы ставим под сомнение предложения перейти на микросервисы, если ограничивающим фактором остаётся неэффективный запрос. Перенос этого запроса за сетевую границу не меняет саму работу. При этом он добавляет ещё одну единицу развёртывания и новые возможности для отказа.
Мы также рекомендуем регулярное нагрузочное тестирование вместо единственной проверки перед запуском. Изменения структуры и распределения данных могут ухудшить работу без крупного выпуска кода. Обязательства по надёжности должны опираться на измеренные возможности и согласованный объём работ, без безусловных обещаний доступности.
Архитектурные ошибки, которые повышают затраты без роста мощности
Самые дорогие ошибки возникают, когда инфраструктурные решения отрывают от данных о нагрузке. Преждевременное распределение системы и неограниченный параллелизм могут увеличить и затраты, и риск отказа. Прежде чем одобрять улучшение, разберитесь, за счёт какого механизма оно должно сработать.
- Масштабирование не того слоя: дополнительные экземпляры приложения не устранят перегрузку записи в базу данных.
- Общие изменяемые данные между сервисами: прямой доступ к таблицам друг друга связывает выпуски и размывает ответственность.
- Хранение сессий на одном экземпляре: локальное состояние усложняет балансировку и замену экземпляров.
- Цепочки синхронных зависимостей: каждый обязательный вызов добавляет ещё один источник задержек и отказов.
- Повторные попытки без ограничений: повторы могут усиливать перегрузку и дублировать бизнес-эффекты.
- Очереди без правил работы с накопленными задачами: отложенная работа растёт, пока не будут нарушены сроки или лимиты хранилища.
- Контроль только средних значений: общая задержка может скрывать медленные критичные сценарии и рост высоких перцентилей.
- Игнорирование стоимости эксплуатации: компонентам нужны обновления, процедуры восстановления и назначенные ответственные.
Общая база данных может быть осознанным этапом миграции. Документируйте её ограничения и критерии перехода к следующему этапу вместо того, чтобы называть сервисы полностью независимыми. Архитектурные названия должны отражать реальность эксплуатации.
Чек-лист готовности архитектуры к следующему этапу роста
Платформа готова к росту, когда команда может продемонстрировать её мощность, поведение при сбоях и путь восстановления. Используйте этот чек-лист для проверки подтверждений, а не подсчёта установленных технологий. Для каждого пункта отметьте: "проверено", "не проверено" или "не применимо".
Измерения и подтверждение мощности
- Для критичных сценариев заданы измеримые цели по задержке и успешному завершению.
- Панели мониторинга показывают входящую нагрузку, полезную пропускную способность, p95/p99, ошибки и насыщение ресурсов.
- Там, где важна асинхронная работа, видны возраст задач в очереди и объём необработанной работы.
- Проверенная нагрузка включает репрезентативные данные и характерное для пиков соотношение операций.
- Запас мощности учитывает рост, задержки масштабирования и значимые отказы.
Проверки архитектуры и работы с данными
- Экземпляры приложения можно заменять без потери необходимого состояния сессий.
- Тесты масштабирования учитывают лимиты соединений и квоты зависимостей.
- Пригодность реплик определяется требованиями к согласованности чтения.
- Сценарии истечения срока хранения кэша и его недоступности проверены.
- Для асинхронных процессов определены ответственные, правила повторных попыток и сроки завершения.
Проверки восстановления и выпусков
- Для исходящих вызовов заданы тайм-ауты и ограничения параллелизма.
- Повторяемые операции сохраняют корректность благодаря идемпотентности или равноценным механизмам.
- Восстановление из резервных копий отработано, результаты зафиксированы.
- Поэтапные выпуски и процедуры отката охватывают изменения приложения и данных.
- Нагрузочные тесты имеют критерии прохождения и запускаются после значимых изменений.
Расставляйте приоритеты непроверенных пунктов по последствиям для бизнеса. Непроверенный сценарий повторной попытки платежа может заслуживать внимания раньше, чем замедление отчётности. Итогом чек-листа должны стать конкретные действия, ответственные и подтверждения, необходимые для приёмки.
Получите оценку архитектуры на основе проверяемых данных
Оценка архитектуры помогает превратить опасения по поводу роста в инженерный план с приоритетами. Проверка должна определить нагрузку, выявить вероятные узкие места и сравнить варианты улучшений по стоимости и риску. В выводах нужно отделять проверенные результаты от допущений.
Полезные исходные материалы включают архитектурные схемы, свежую телеметрию и ожидаемые изменения нагрузки. Записи об инцидентах и ограничения развёртывания помогают понять, где теоретические решения могут оказаться непрактичными.
Запросите у Webdelo оценку архитектуры и готовности к высокой нагрузке. Подготовьте критичные пользовательские сценарии и ожидания роста, чтобы сосредоточить обсуждение на мощности, надёжности и следующем обоснованном вложении.
Общий словарь для архитектурных решений
Обсуждать высокую нагрузку проще, когда технические и бизнес-заинтересованные стороны используют одинаковые определения. Эти термины описывают нагрузку, поведение системы при эксплуатации и обязательства по надёжности. Каждый нужно связывать с конкретной системой и контекстом измерения.
- RPS
- Количество запросов в секунду. Важно различать входящие запросы и успешно завершённые операции.
- Задержка p95 и задержка p99
- Границы времени отклика, в пределах которых завершаются 95 % и 99 % измеренных запросов соответственно.
- Насыщение ресурсов
- Нагрузка на ограниченный ресурс, которая часто проявляется в ожидании или исчерпании доступной мощности.
- Отставание очереди
- Разница между поступившей и обработанной работой. Выражается числом накопленных задач, разницей позиций в журнале или временной задержкой.
- Горизонтальное масштабирование
- Добавление экземпляров или узлов для распределения работы.
- Реплика для чтения
- Копия базы данных для запросов на чтение, которая может отставать от последних изменений на основном узле.
- Идемпотентность
- Свойство операции, при котором её повторение не создаёт дополнительного целевого бизнес-эффекта.
- Автоматический выключатель
- Механизм, который временно блокирует вызовы к сбоящей зависимости, а затем проверяет её восстановление.
- SLO
- Целевой уровень обслуживания, задающий измеримую цель за определённый период.
- SLA
- Соглашение об уровне обслуживания, которое устанавливает договорные обязательства и последствия их нарушения.
- Бюджет ошибок
- Объём сбоев, допустимый по SLO за период его измерения.
- Наблюдаемость
- Возможность понимать поведение системы по таким сигналам, как метрики, логи и трассировки.
Опирайтесь на измеренные ограничения при следующем архитектурном решении
Высокая нагрузка - это вопрос характера работы и бизнес-рисков. Жизнеспособная архитектура начинается с чётких целей сервиса и данных о текущем ограничении. Дополнительная инфраструктура оправдана, когда устраняет это ограничение, а затраты на её эксплуатацию остаются посильными для команды.
Модульный монолит может стать прочной основой, а событийные подходы совместимы с любой моделью развёртывания. Надёжность обеспечивают контролируемые зависимости и проверенное восстановление. Следующее полезное решение - минимальное изменение, пользу которого вы можете доказать при репрезентативной нагрузке.
Часто задаваемые вопросы
Когда системе действительно нужна архитектура для высокой нагрузки?
Она нужна, когда нагрузка приближается к практическим пределам системы и угрожает требуемой производительности или корректности данных. Единого порога RPS для высокой нагрузки не существует. API оформления заказа на 200 RPS бывает сложнее масштабировать, чем статический сайт на 20 000 RPS за CDN. Начните с профиля нагрузки: пропускная способность, конкурентность, задержки p95/p99, ошибки, насыщение ресурсов, рост данных и отставание очередей по каждому критичному сценарию.
Что обычно первым перестаёт справляться при росте трафика?
В системах с большим числом транзакций первым узким местом часто становится база данных: нет нужных индексов, есть конкуренция за блокировки, запросы N+1 или исчерпан пул соединений. Мощности также могут закончиться из-за лавины промахов кэша, медленных синхронных интеграций и растущих очередей, хотя CPU приложения при этом выглядит свободным. Прежде чем добавлять серверы, найдите, где запросы ждут. Новые экземпляры приложения могут ухудшить ситуацию, потому что каждый открывает ещё один пул соединений к той же базе.
Стоит ли переходить с монолита на микросервисы, чтобы выдержать большую нагрузку?
Только если вам нужны независимое владение, развёртывание или масштабирование, а команды готовы сопровождать сервисы в продакшене. В Webdelo мы обычно советуем начать с модульного монолита: одно развёртывание, чёткие границы доменов и понятное владение данными. Выделять сервис стоит, когда у модуля другой профиль нагрузки или другой ритм релизов. Если предел задаёт медленный запрос, перенос его за сетевую границу ничего не решит и добавит новую точку отказа.
Является ли событийная архитектура альтернативой микросервисам?
Нет. Событийный подход - это способ взаимодействия, а не отдельная модель развёртывания. Монолит может отправлять события фоновым обработчикам, а микросервисы могут использовать синхронные API, события или и то, и другое. Выбирайте подход для каждой бизнес-операции: уведомления и отчёты могут подождать, а резервирование товара часто требует немедленного ответа.
Почему при нагрузочном тестировании важнее задержки p95 и p99, а не среднее значение?
Среднее скрывает медленный «хвост», который реально ощущают пользователи критичных сценариев. Резкий рост p99 часто указывает на растущие очереди или конкуренцию за ресурсы раньше, чем изменится среднее. Смотрите перцентили вместе с RPS, ошибками и насыщением и отделяйте успешные запросы от неуспешных: быстрые ошибки улучшают картину задержек. Рабочий предел - это максимальная проверенная нагрузка, которая выполняет ваши критерии с запасом.
Как сделать повторные попытки и повторную доставку сообщений безопасными?
Закладывайте идемпотентность: повторная обработка той же операции не должна создавать второй бизнес-эффект. Обычно уникальный идентификатор операции сохраняют в той же транзакции базы данных, что и защищаемое изменение. Если изменение в базе должно ещё и публиковать событие, согласованность обеспечивает transactional outbox. Ограниченные тайм-ауты, backoff с jitter и лимит повторов не дают повторным попыткам усиливать перегрузку.
Что даёт оценка архитектуры высоконагруженной системы от Webdelo?
Она превращает опасения по поводу роста в план работ с приоритетами. Обычно на выходе вы получаете карту зависимостей, список узких мест по важности, варианты архитектуры с явными компромиссами и оценку мощности, привязанную к проверенной нагрузке и окружению. Для оценки пригодятся архитектурные схемы, свежая телеметрия, ожидаемый рост нагрузки, записи об инцидентах и ограничения развёртывания. В выводах проверенные факты отделены от допущений.