

Service Level Agreement — поддержка и сопровождение
Целевые значения и процессы для инцидентов, дефектов и уязвимостей. Документ применяется к заказной разработке на инфраструктуре клиента; обязывающие условия фиксируются в SOW. Каждый раздел — короткие тезисы и сводные таблицы для быстрой оценки отделом закупок, CTO и службой безопасности.
 Тикет — единый канал учёта
 CET/CEST · 24×7 по плану
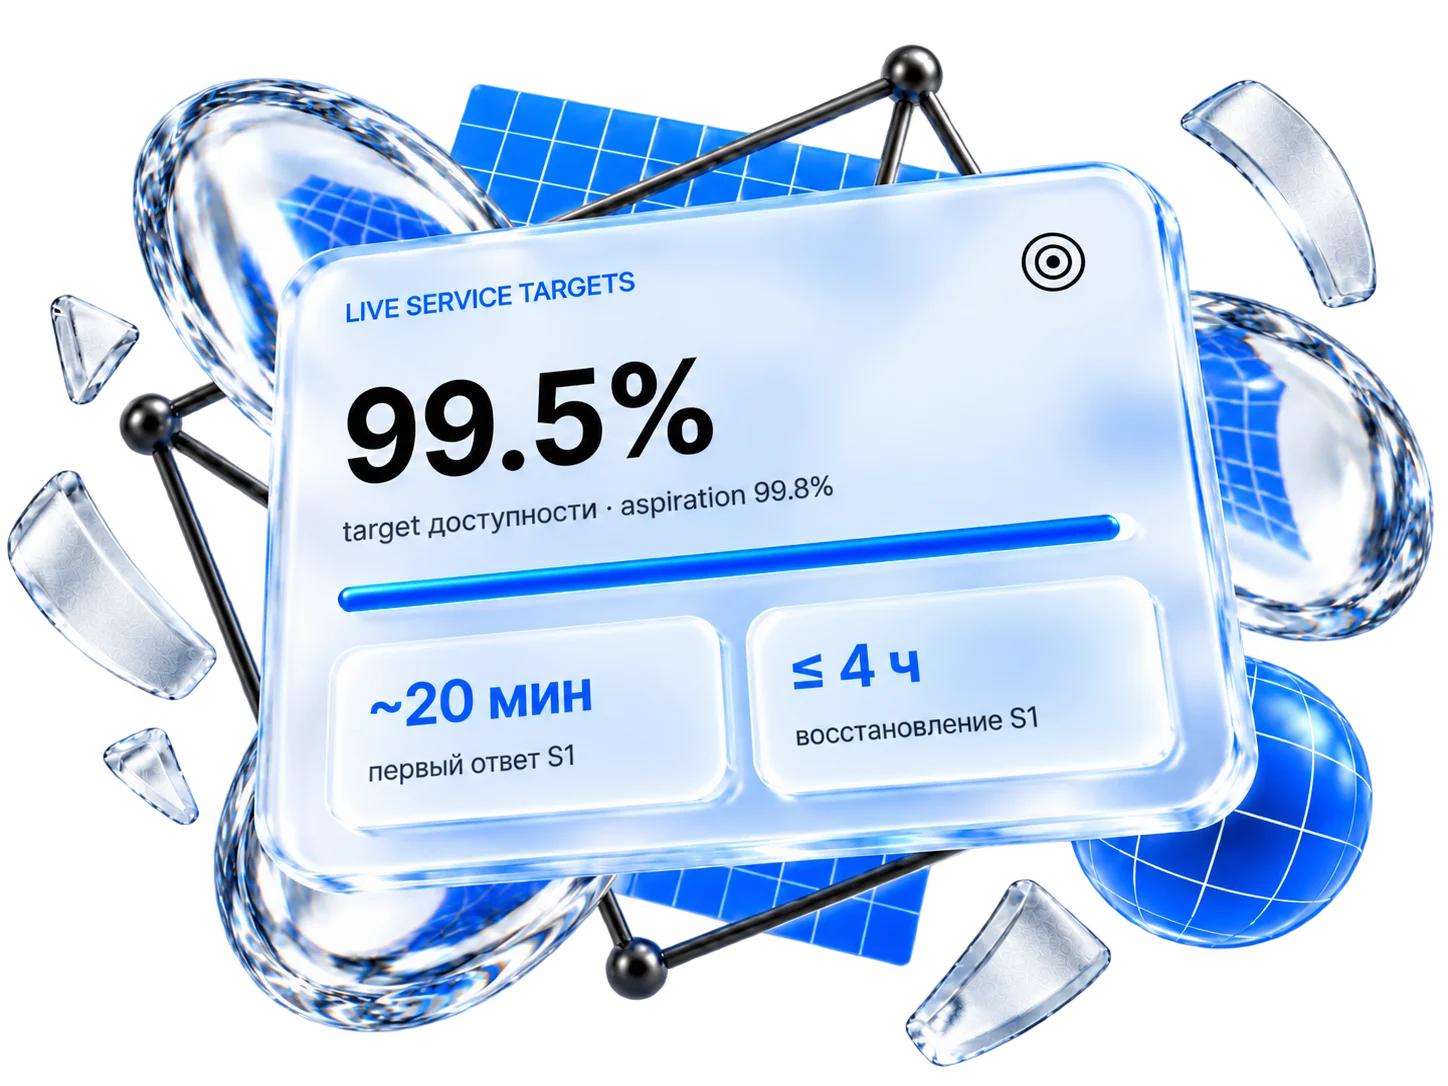
 S1 · первая реакция ~20 мин
 S1 · восстановление до 4 ч
 Уведомление об инциденте безопасности до 48 ч
 EN · RU · DE
Ключевые факты
SLA описывает целевые значения для инцидентов, дефектов и уязвимостей. По умолчанию — рабочие часы CET/CEST; круглосуточное дежурство (24×7) — по тарифу. Для критичных инцидентов восстановление сервиса приоритетнее глубокого анализа первопричины (RCA).
первая реакция на S1 в рабочие часы
восстановление S1 (в зоне нашего контроля)
целевая доступность (ориентир 99.8%)
плана: Basic · Extended · Enterprise
Канал
Тикет — единый канал учёта по SLA
Обращения из чатов могут фиксироваться в тикетах для учёта и отчётности.
 Покрытие
CET/CEST по умолчанию
Расширенные часы и круглосуточное дежурство — по плану. Структурное преимущество для клиентов из США.
 Подход
Сначала восстановление
Для S1/S2 минимальное восстановление сервиса приоритетнее полного устранения первопричины.
 Онбординг
Обязателен для реалистичных показателей
Без онбординга точные целевые значения SLA не устанавливаются — особенно для унаследованных систем.
 Языки
EN · RU · DE
Полная поддержка EN/RU. DE — доступно. Прочие — по согласованию. Перевод с помощью ИИ — опционально.
 Контракт
Условия — в SOW
Сервис-кредиты, RPO/RTO, матрица эскалации, уведомление об инцидентах безопасности, QBR — в приложении к договору.
Правовая оговорка / Отказ от ответственности SLA
Настоящая страница является информационным описанием целевых показателей и операционных процессов и не является публичной офертой в соответствии с п. 2 ст. 437 Гражданского кодекса Российской Федерации. Указанные значения носят ориентировочный характер и не порождают одностороннего обязательства по оказанию услуг в соответствии с гл. 39 ГК РФ (ст. 779–783). Настоящая страница предназначена для ознакомительных целей и адресована специалистам по закупкам и руководителям технических подразделений. Все обязательные обязательства, меры ответственности и гарантийные обязательства возникают исключительно из индивидуально подписанного договора / SOW.
Область действия SLA: что покрыто, исключения, границы ответственности
SLA покрывает заказную разработку на инфраструктуре клиента. Действует модель разделённой ответственности: код и развёртывание — наша зона; инфраструктура и сторонние сервисы — зона клиента. Если первопричина вне нашего контроля, обеспечиваем диагностику и координацию.
 В области действия

Инциденты в продуктивной среде — доступность и ключевые процессы
Исправление ошибок в критичных процессах: оформление заказа, платежи, вход в аккаунт
Уязвимости и инциденты безопасности (высокий приоритет)
Координация со сторонними поставщиками (по плану)
 Исключения

Отказы дата-центров и инфраструктуры вне нашего управления
Отказы сторонних сервисов (платёжные системы, API, сервисы email-рассылок)
Подсистемы, не разработанные нашей командой (только диагностика)
Случаи, когда не предоставлен необходимый доступ
Модель разделённой ответственности
 Наша ответственность
 Ответственность клиента
 Приложение
 Инфраструктура
 Сторонние сервисы
 Совместно

Когда первопричина вне нашего контроля, мы определяем проблемную зависимость, предоставляем технический контекст и логи, выступаем посредником в коммуникации с поставщиком (если включено в план), фиксируем выводы в тикете и предлагаем меры по снижению влияния на нашей стороне.
Определения: тикет, инцидент, дефект, запрос на изменение, первая реакция
Тикет — базовая единица учёта по SLA. Инцидент — сбой в продуктивной среде. Дефект — некорректное поведение существующей функции. Запрос на изменение — плановая работа, а не инцидент. Срочные изменения с внешними сроками могут быть приоритизированы вне очереди.
Первая реакция · Восстановление · Полное устранение
Подтверждение и начало работ
Тикет принят, команда подтвердила получение и начала работу. Эскалация — если нужны другие роли.
Минимальное восстановление
Возврат сервиса к рабочему состоянию, даже в режиме ограниченной функциональности. Подход по умолчанию для критичных инцидентов.

Устранение первопричины
Полное исправление первопричины. В сложных случаях — после восстановления сервиса.
Часы поддержки, часовые пояса, праздники, языки
Покрытие по умолчанию — рабочие часы CET/CEST. Расширенное покрытие включает реакцию в нерабочее время, дежурного инженера с перекрытием по часовому поясу клиента и планирование релизов в удобные окна. Календарь праздников согласуется с местом оказания услуг и фиксируется в SOW.


Поддерживаемые языки
 Английский — полностью
Русский — полностью
 Немецкий — доступен
Другие — по согласованию
Перевод с помощью ИИ — опционально
Каналы приёма заявок и обязательные данные
Официальный канал учёта по SLA — тикет-система. Запрос должен содержать описание, временное окно, место (страница / маршрут / API), влияние на бизнес и, по возможности, скриншоты, логи, идентификаторы трассировки (trace ID). Без необходимого доступа поддержка может быть ограничена изменениями на уровне репозитория.
 Минимальные поля в запросе
Что произошло — короткое описание
Когда — временное окно
Где — страница / маршрут / API / окружение
Влияние на бизнес — что заблокировано, кто затронут
Критичность — оценка от клиента (по возможности)
Материалы — скриншоты, логи, trace ID, сообщения об ошибках
 Доступ и операционные ограничения

Без доступа к продуктивной среде поддержка ограничена изменениями на уровне репозитория

Сбои инфраструктуры (CI/CD, среда выполнения) не решаются без доступа к соответствующему уровню

Требования к доступу устанавливаются на онбординге

Чаты можно использовать, но обращения обязательно фиксируются в тикетах для учёта по SLA
Модель приоритетов: критичность S1–S4 и соответствие P0–P4
Четырёхуровневая модель критичности, совместимая с принятой в корпоративной практике шкалой приоритетов P0–P4. S1/P0 — полная или частичная недоступность. S2/P1 — серьёзное ухудшение работы при наличии обходного решения. S3–S4 — ограниченное влияние, плановая очередь.
Целевые показатели: реакция, восстановление, коммуникация
Финальные целевые значения зависят от плана и фиксируются в SOW. Типовая первая реакция на S1 в рабочие часы — ~20 мин. Цель восстановления для S1 — до 4 ч (когда причина в нашей зоне контроля). Частота обновлений статуса — от каждых 30 мин (Enterprise) до каждых 4 ч (Basic).
Восстановление и полное устранение
Частота обновлений по тарифу

Этапы коммуникации
Принято
обращение принято, работа начата

Диагностика
зона отказа локализована
Восстановлено
временное устранение применено
Устранено
полное исправление выпущено

Рекомендации
RCA-разбор и дальнейшие шаги

Заблокировано
нет доступа или данных от клиента

Если прогресс заблокирован отсутствием доступа или данных от клиента, работа может быть приостановлена. Время ожидания засчитывается, если не согласовано иное, поскольку инцидент невозможно устранить без необходимых условий.
Эскалация: роли, уровни, подключение руководства
Трёхуровневая схема: дежурный инженер → техлид / руководитель проекта → CTO / архитектор. Эскалация запускается немедленно, если не хватает знаний предметной области или доступа. Для Enterprise временные пороги фиксируются в SOW.
Уровни эскалации
Дежурный / назначенный инженер — первым берёт инцидент в работу
Руководитель проекта / техлид — отвечает за предметную область
CTO / архитектор — сложные и критичные случаи
CEO — финансовые потери, репутационный риск
Временные пороги (S1, Enterprise)
Когда происходит эскалация
Немедленно
Не хватает знаний предметной области
У первого ответственного нет экспертизы в платежах или инфраструктуре либо нужного доступа.
По ходу работ
Расследование уходит вглубь
Расследование затрагивает подсистему, к которой у нас нет доступа, или требует другой экспертизы.
Руководство
Прямые потери / безопасность
Финансовые потери, репутационный инцидент, инцидент безопасности — нужно быстрое сдерживание.
Управление инцидентами · RCA · мониторинг
Для S1/S2 сначала восстанавливаем сервис, потом проводим глубокий анализ. Меры по снижению влияния — отключение функции, блокировка маршрута, срочное исправление. RCA-разбор — после стабилизации, в сжатом формате. Мониторинг по плану: синтетические проверки доступности, контроль срока действия сертификатов, проверки содержимого страниц, метрики инфраструктуры.
Меры по снижению влияния
Отключить или ограничить функцию
Временное отключение проблемного блока, чтобы не допустить каскадных сбоев.
Заблокировать маршрут или адрес API
Изоляция перегруженного маршрута, чтобы остановить распространение нагрузки.
Экстренное снижение нагрузки
Снижение нагрузки на инфраструктуру до диагностики приложения.
Точечное срочное исправление
Узкое исправление конкретной проблемы, когда причина ясна.
Экстренный откат
Откат недавнего изменения при подозрении на регрессию.
Ограниченный режим
Работа с ограниченной функциональностью, пока продолжается полное восстановление.
RCA-разбор инцидента
Мониторинг по плану
Уязвимости и инциденты безопасности
Уязвимости и инциденты безопасности — высокий приоритет: сдерживание, сокращение окна уязвимости, привлечение старших технических специалистов. Для Enterprise срок уведомления о подтверждённом инциденте — до 48 часов (до 24 часов по отдельному соглашению). Клиента уведомляют и о найденных уязвимостях высокого риска до подтверждения их эксплуатации.
 Принцип 1
Сначала сдерживание
Быстрые меры, чтобы закрыть окно уязвимости до глубокого анализа.
Принцип 2
Проверка
Подтверждение, что уязвимость заблокирована или находится под контролем.
Принцип 3
Участие старших специалистов
Привлечение старших технических ролей при необходимости.
Уведомление клиента
Практики безопасной разработки

Сертификация. SOC 2 / ISO 27001 на текущий момент не оформлены; получение запланировано в горизонте 12–15 месяцев. Опросник по безопасности с описанием применяемых мер контроля — по запросу.
Данные, доступы, качество кода и тестов
По умолчанию данные обрабатываются на инфраструктуре клиента. Тестовая среда у Webdelo — только для некритичных проектов или при отсутствии доступа к продуктивным данным (с тестовыми данными). При расторжении договора доступы отзываются контролируемо. Целевое автоматизированное тестовое покрытие — не менее 90%, для критичных бизнес-путей — 100%.
Модель работы с данными
Качество кода и тестовое покрытие

Модульные и интеграционные тесты; типы и глубина — по проекту в SOW.

Платежи, данные клиентов, ключевая бизнес-логика, аутентификация — полное покрытие.

Статический анализ в CI/CD; SAST/DAST — по SOW.

Если клиент решает сократить тестовое покрытие для оптимизации бюджета, решение фиксируется письменно (тикет, email, дополнение к SOW). Клиент принимает связанные риски: рост вероятности регрессий, увеличение времени диагностики и стоимости будущих изменений; решение и его влияние фиксируются в реестре рисков проекта.
Управление изменениями: согласование, окна, откат, экстренные изменения
Изменения проходят структурированный процесс согласования через тикет. Для Enterprise возможна интеграция с процессом клиента (спринты, комитет по изменениям). План отката обязателен для критичных изменений. Экстренные изменения при полном отказе могут применяться без предварительного согласования; клиент уведомляется сразу после.

Что считается изменением
Развёртывание кода (новые функции, исправления, рефакторинг)
Обновление зависимостей и фреймворков
Конфигурация (переменные окружения, маршрутизация, правила доступа)
Изменения инфраструктуры в зоне нашего управления
Окна обслуживания
Небольшие проекты — развёртывание в рабочие часы без формального окна
Enterprise и критичные системы — окно фиксируется в SOW
Расписание под рабочие часы клиента (ночь / раннее утро)
Лица, уполномоченные согласовывать изменения, фиксируются в SOW
Тарифные планы поддержки: Basic · Extended · Enterprise
Три плана с растущим уровнем покрытия и обязательств. Цены не публикуются: стоимость зависит от стека, числа интеграций, требуемого грейда инженеров, требований к коммуникации, отчётности и обработке данных. Все условия фиксируются в SOW.
 Enterprise
Доступность 99.5%: где она применима
— для систем, где у нас полный доступ к уровню приложения и процессу развёртывания, а инфраструктура стабильна и под достаточным контролем. Не публикуется как безусловная гарантия: зависит от хостинг-провайдера, сторонних сервисов, своевременности доступов от клиента и зрелости архитектуры. Цели для конкретного проекта фиксируются в SOW после аудита.
Почему цен нет на странице

Сложность технологий
Микросервисы на Go, Laravel, Symfony, унаследованные системы, смешанные среды.
Третьи стороны
Платежи, внешние API, поставщики данных — каждая интеграция увеличивает сложность.
Ведущие инженеры или стандартная команда
Состав команды зависит от критичности и сложности системы.

Частота и каналы
Частота обновлений, режим 24×7, число каналов напрямую влияют на стоимость.

Инструменты и интеграции
Jira, ServiceNow, доступ к дашбордам, индивидуальные отчёты.
Глубина практик
Аудиты, тестирование на проникновение, ограничения на ИИ и обработку данных.
Enterprise · договорные приложения (SOW)
Шесть областей договорных обязательств в Enterprise-плане: сервис-кредиты, матрица эскалации, частота обновлений статуса, RPO/RTO, уведомление об инцидентах безопасности, сервис-ревью (QBR). Все условия фиксируются в SOW и могут адаптироваться с пересчётом стоимости поддержки.

Сервис-кредиты
Работы по S1 не начаты в пределах целевого времени первой реакции
от 2% месячной стоимости поддержки за инцидент
не более 30% месячной стоимости поддержки за период
Сервис-кредит — скидка на следующий расчётный период
Только ко времени первой реакции, не к сроку полного устранения
Проценты, лимиты, метрики настраиваются с пересчётом стоимости поддержки

Аварийное восстановление: RPO / RTO и бэкапы
Определяются для каждой системы после аудита
БД, файловые хранилища, кеши, очереди и пр.
полный / инкрементальный / дифференциальный
Срок хранения — в SOW
MySQL + Redis + MongoDB и иные комбинации
Рекомендация — не реже 1 раза в месяц для продуктивных систем
Тестирование аварийного восстановления
 Частота
Ежемесячно — рекомендация
Для критичных систем — раз в две недели или еженедельно, если клиент готов выделить бюджет.
 Охват
Файловая система + все БД
Файловая система и все базы (реляционные, NoSQL, кеши, очереди).
 Тестовые маркеры
Маркеры в данных
Записи-маркеры готовятся заранее — так проверяется восстановление и старых, и новых данных.
Сервис-ревью · QBR
Отчёт по тикетам, основные инциденты, риски стабильности
План действий, улучшения мониторинга, рекомендации по стабилизации и рефакторингу
То же + углублённый анализ трендов
Расширенные рекомендации
Онбординг · унаследованные системы · непрерывность
Онбординг обязателен для реалистичных целевых значений: настройка доступа, обзор архитектуры и зависимостей, выявление критичных бизнес-процессов, анализ истории инцидентов, согласование мониторинга. Для унаследованных систем этот этап дольше, а тот же уровень гарантий, что для систем собственной разработки, обеспечить нельзя. Непрерывность обеспечивается документацией, регламентами и снижением зависимости от отдельных специалистов.
Онбординг · сроки
Онбординг нового члена команды
Унаследованные системы — принципы
Не препятствие
Унаследованный код — не повод отказаться от проекта.
Честные ожидания
Мы не можем обеспечить тот же уровень гарантий, что для систем собственной разработки.
Онбординг критичен
Обследование архитектуры, карта зависимостей, оценка рисков.
Постепенное улучшение
Сначала стабилизация, затем плановый рефакторинг как отдельное направление работ.
Бюджет на обследование
Начальная оценка определяет реалистичные цели SLA.
Тесты + документация
Самый быстрый путь к более высокому уровню сервиса.
Непрерывность и управление знаниями
FAQ: быстрые ответы для проверки закупками и инженерией
Ответы на ключевые вопросы: официальный канал — тикет-система, покрытие — CET/CEST с опцией 24×7, модель критичности S1–S4 (P0–P4), первая реакция ~20 минут (критические), ориентир восстановления S1 — до 4 часов (в нашей зоне ответственности), целевая доступность 99,5% (SOW), сервис-кредиты для Enterprise (SOW), эскалация с порогами 4/8/12ч, обновления статуса от 30 минут (Enterprise S1) до 2 часов (Extended S1), управление изменениями с планами отката, данные на инфраструктуре заказчика, сертификация не получена (план 12–15 месяцев), ИИ-поддержка опционально, русский/английский/немецкий, цены — в SOW.
