


С чего началась оптимизация ИИ-процессов
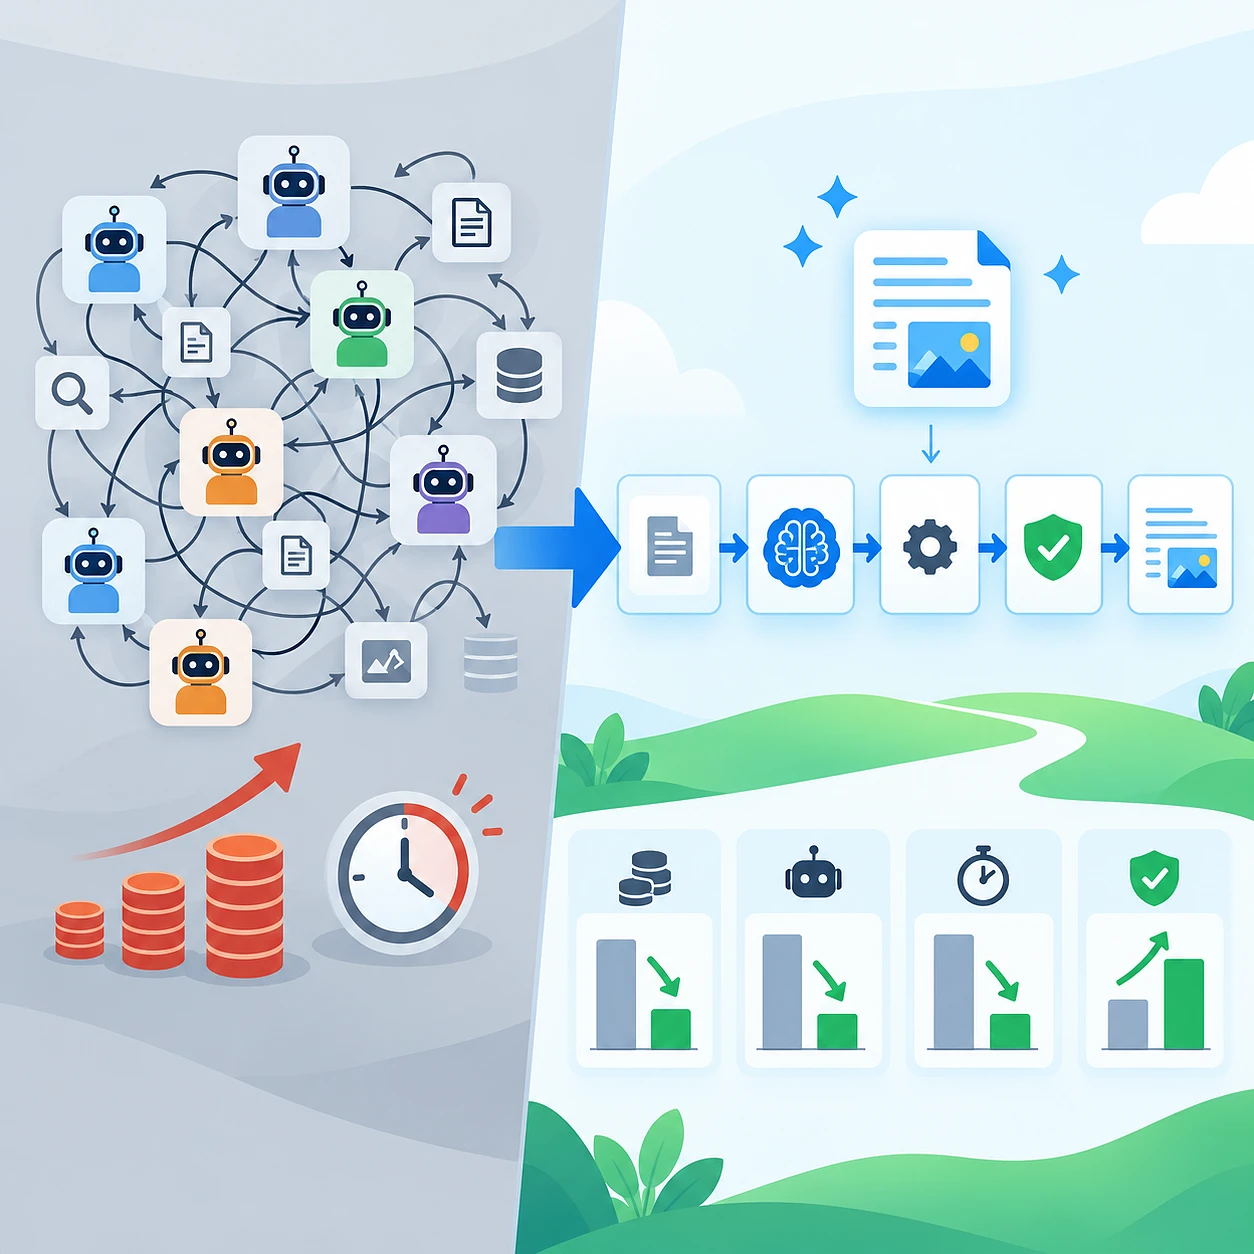
Это реальный кейс из нашей собственной контент-платформы, а не пересказ чужих материалов. Оптимизация ИИ-процессов началась с замеров. В агентном режиме на одну статью уходило в медиане 197 вызовов модели и 34,2 минуты. Мы перенесли рутинную работу в детерминированный код, а модель оставили только там, где нужен смысл. После этого три одинаковых реальных брифа потребовали 13, 10 и 6 вызовов модели. Общая стоимость в эквиваленте снизилась с $95,32 до $35,13 (в 2,71 раза), а общее время сократилось с 94,2 до 36,8 минуты (в 2,56 раза быстрее). С учётом перезапусков, которые агентному режиму действительно понадобились, разница достигла 4,86 раза по стоимости и 4,40 раза по времени.
Одно уточнение до подробностей. Все суммы в долларах здесь - эквиваленты, рассчитанные по публичным тарифам моделей, а не счёт к оплате. Проект работает по подписке, поэтому реальная экономия выражается в лимитах использования и пропускной способности. Долларовый эквивалент мы используем потому, что это самый наглядный способ сравнить, сколько ресурсов потребляет каждый подход.
Работа изменила и наше понимание качества. Те же проверки в коде, которые удешевили пайплайн, нашли дефекты в уже опубликованных статьях: пропущенные ссылки, дублирующиеся ссылки и ссылку на домен другого языка. Агентная схема пропустила их все.
Мы писали этот материал для владельцев, CEO, COO, руководителей продуктов и операционных подразделений в B2B-компаниях среднего размера, которые оценивают автоматизацию реальных бизнес-процессов с помощью ИИ. Глубокие технические знания для чтения не нужны. Вот что будет дальше:
- бизнес-задача и то, что мы измерили в первую очередь;
- почему добавление агентов только ухудшило бы ситуацию;
- архитектура, на которую мы перешли, и сравнение "до и после";
- результаты бенчмарка, рост надёжности и пойманные дефекты;
- что это значит для проектов с ИИ в ERP, CRM и других корпоративных системах;
- честные ограничения кейса и то, что мы планируем проверить дальше.
Бизнес-задача: ИИ работал, но обходился слишком дорого
Наша система уже выполняла свою работу: превращала бриф в опубликованную многоязычную статью в CMS. Но каждый запуск требовал сотен вызовов модели и больше получаса. Качество результата было приемлемым. Трудность была в экономике и в том, насколько непредсказуемым стал процесс, а с ростом объёмов и то и другое только ухудшалось бы.
Если говорить просто, платформа берёт бриф и проводит его через цепочку шагов. Она собирает контекст и исследования с уровнями авторитетности источников, строит структуру, пишет основной текст, переводит его, добавляет внутренние ссылки, готовит метаданные, FAQ и медиа и публикует всё в CMS. Статьи поддерживают наше сео продвижение сайтов и продвижение в Ai, поэтому они должны быть точными на каждом языке. Ни один из этих бизнес-шагов в ходе оптимизации мы не меняли. Мы поменяли только исполнителя каждого шага.
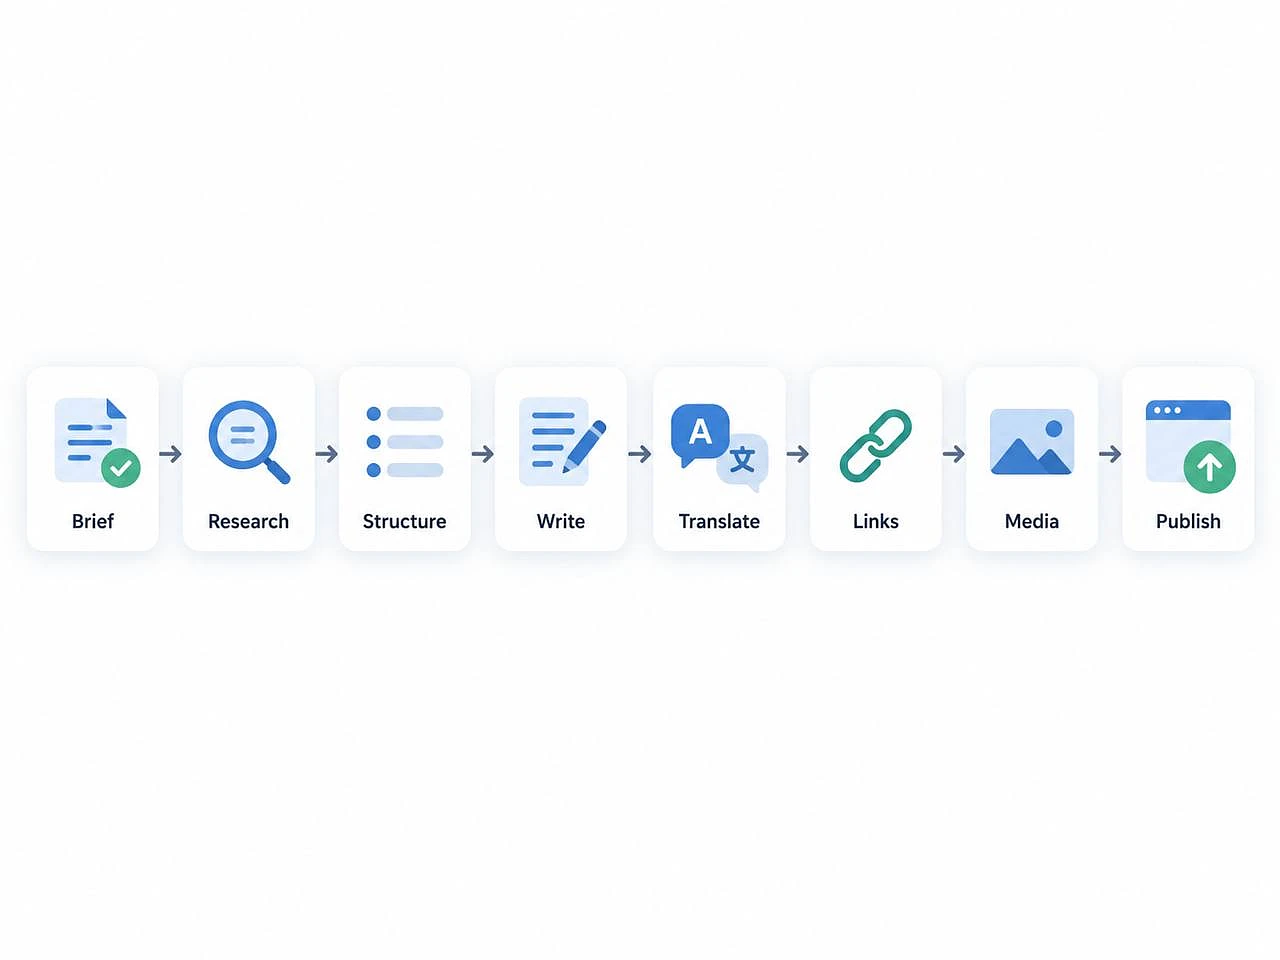
Старая схема была мультиагентной и работала на Claude Code. Модель-оркестратор запускала более десяти субагентов, по одному на фазу. Каждый субагент получал не сами данные, а пути к файлам. Дальше ему приходилось читать эти файлы, разбираться, как подписывать запросы к API, писать временные скрипты, править текст мелкими фрагментами и самому докладывать о статусе.
Мы измерили 11 полных запусков в агентном режиме. Медианная стоимость составила $42,49 в эквиваленте на статью при разбросе от $20,87 до $66,39. В медианном запуске было 234 вызова инструментов. Трёхкратную разницу между самой дешёвой и самой дорогой статьёй сложно заложить в план, даже когда среднее значение выглядит терпимо.
Для бизнеса это знакомый риск автоматизации процессов с ИИ. Стоимость единицы непредсказуема, перезапуски незаметно её увеличивают, а каждый дополнительный язык или необязательная фаза умножают расходы. Поэтому снижение затрат на ИИ-агентов становится актуальным для любой компании, которая автоматизирует реальный процесс, от обработки заказов до поддержки клиентов: в эту стену упираются, как только пилот превращается в ежедневную работу.
Что мы измерили и что нас удивило
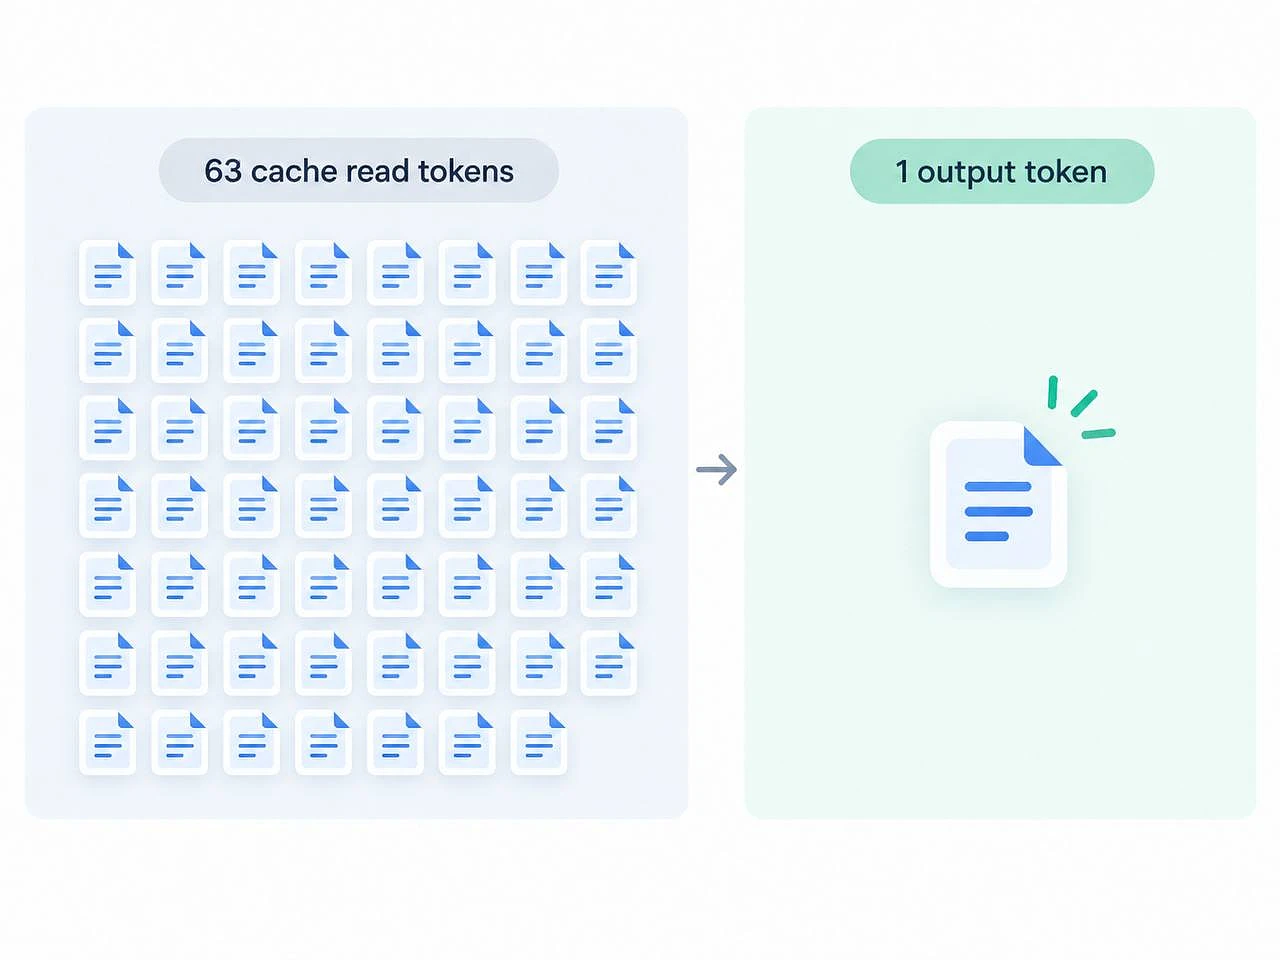
Затраты возникали не на написании текста. Они возникали из-за того, что агенты снова и снова перечитывали свой контекст: в среднем 12,7 млн токенов чтения из кэша против 202 тыс. выходных токенов, то есть около 63 прочитанных токенов на каждый написанный. А дорогая модель, которую мы подозревали, во время генерации вообще не работала.
Мы начали с простого вопроса владельца продукта и ответили на него, разобрав транскрипты сессий построчно. Догадки привели бы нас к замене моделей, а это ничего бы не исправило.
63 прочитанных токена на каждый сгенерированный
Средний агентный запуск потреблял 12 734 402 токена чтения из кэша, 833 199 токенов записи в кэш, 202 319 выходных токенов и всего 375 новых входных токенов. Проще говоря, модель постоянно платила за повторное чтение одних и тех же документов вместо того, чтобы создавать полезный текст.
Один запуск оркестратора показывает, как это происходит. За 22 минуты он сделал 71 вызов модели, и 21 из них были короткими сообщениями без действий вроде "читаю бриф". Его контекст вырос с 17 тыс. до 91 тыс. токенов, и каждый вызов перечитывал его целиком. Соотношение 63:1 - это среднее по нашей системе, и его не стоит считать универсальным для языковых моделей.
Дорогая модель была ни при чём
Владелец продукта спросил, стоит ли оставлять дорогую модель на оркестраторе, ведь после её включения генерация "перестала терять шаги". Транскрипты дали неожиданный ответ. Флаг на бэкенде переопределял настройки агентов, и во всех 106 сессиях генерации работал Sonnet.
Стабильность обеспечили исправления инструкций и машинная проверка в конце запуска, которую мы называем preflight-гейтом. Выбор модели роли не играл. Кроме того, на оркестратор приходилось 23,5% вызовов модели и всего 4,7% стоимости, так что экономить на нём было бессмысленно.
Ловушка измерений, удвоившая наши затраты
Наши первые цифры были ошибочны примерно в два раза. Один ответ модели записывается в транскрипт несколькими строками (текст, рассуждение, каждый вызов инструмента), и в каждой строке повторяются одни и те же данные об использовании. Суммирование строк давало $95,43 за один запуск, а подсчёт уникальных ответов - $48,37.
Мы исправили методику, убрав дубликаты по ID ответа. Относительные выводы сохранились, но абсолютные цифры изменились. Урок для бизнеса простой: прежде чем принимать решения на основе числа, проверьте, как оно посчитано.
Почему больше агентов - не решение
Добавление агентов или более сильной модели только сделало бы те же ошибки дороже. Агенты не бились над сложными задачами. Они боролись с окружением: подписывали вызовы API, искали файлы, разбирали ответы и вставляли ссылки по одной.
Мы не согласны с популярной идеей, что больше автономии означает лучшую автоматизацию. Для чётко определённых процессов наши данные показывают обратное, и оптимизация ИИ-агентов здесь начинается с сокращения их свободы. Наглядный пример - интерлинкер: бэкенд уже выбрал страницы, анкоры и оценки релевантности, и модели оставалось только вплести ссылки в абзацы. Это работа на один вызов. На неё уходило до 91 вызова, 26 из которых вставляли по одной ссылке за правку, а в 24 запусках число вызовов колебалось от 3 до 91.
Ошибки окружения, а не сложные задачи
Мы насчитали 69 ошибок инструментов в 10 запусках, около семи на генерацию. Ошибки встречались в 27 запусках из 30, а финальный скрипт приходилось перезапускать в 11 из 30. Причины не имели отношения к сложности задачи:
- переменные окружения, потерянные между вызовами оболочки: 13;
- сбои финального скрипта: 13;
- разбор ответов: 7;
- отсутствующие файлы по ожидаемым путям: 7;
- правки, не нашедшие целевую строку: 6;
- сетевые вызовы, заблокированные хуком безопасности: 6;
- инструмент недоступен в субагенте: 4.
Интерлинкер к тому же подписывал запросы по устаревшей схеме и получал ошибки 401, а его инструкции ссылались на модуль подписи, которого не существовало.
Выдуманные данные и расползающиеся форматы
Часть "данных" агентов была выдумана. В 92 запусках субагента ключевых слов ни один не получил реальных данных Google: пакет отсутствовал, а токен был недействителен. Модель придумывала ключевые слова и помечала их как "manual".
Анализ конкурентов выполнялся вручную, хотя скрипты для него уже существовали. Файл keywords.json существовал в четырёх несовместимых форматах, а одновременно использовались три схемы подписи. Для бизнеса это самый опасный вывод: агент может скрывать сломанные интеграции за правдоподобно выглядящим результатом.
Что мы изменили в архитектуре ИИ-процессов
Мы заменили сеть агентов детерминированным пайплайном. Код собирает данные, формирует промпты, записывает файлы, запускает проверки и распределяет работу. Модель выполняет один сфокусированный инференс LLM на фазу, без инструментов и с полностью подготовленным контекстом, а её результат проходит валидацию до начала следующего шага.
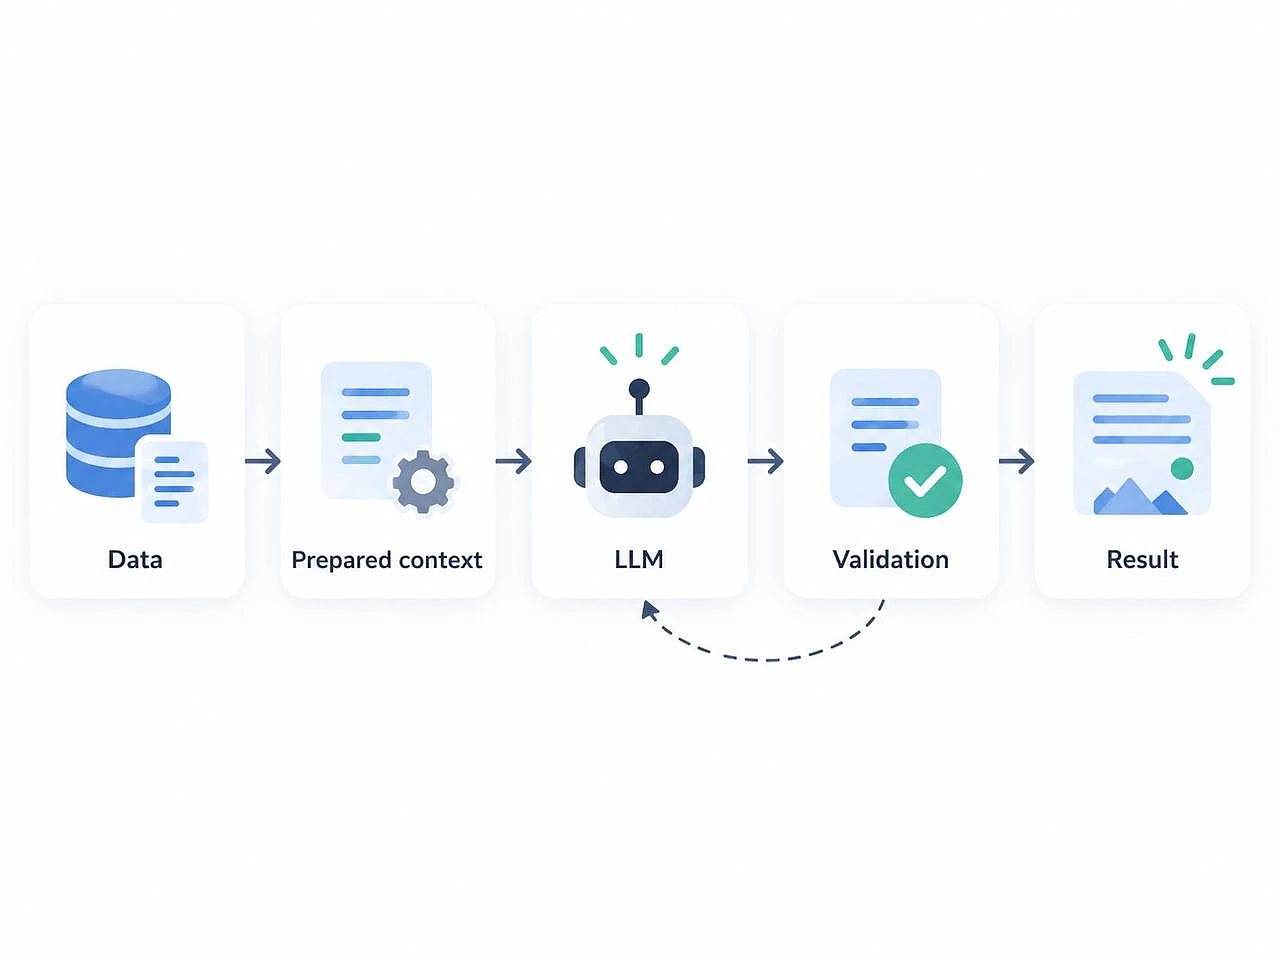
Для читателя без технической подготовки принцип выглядит как прямая линия: Данные -> Подготовленный контекст -> LLM -> Валидация -> Результат. Весь проект, от анализа и реализации до бенчмарка, исправлений и переключения продакшена, занял один рабочий день. Он дал 144 коммита и 652 автоматических теста, а все реальные запуски модели обошлись примерно в $82 в эквиваленте, меньше двух агентных генераций длинной статьи.
Модель делает только то, что требует смысла
В новом пайплайне модель тратит токены только на написание, перевод и синтез смысла. Всё, что окружает эту работу, - код. Скрипты подставляют фактическое содержимое в шаблоны промптов, поэтому модель больше не получает пути к файлам и не ищет входные данные сама.
Мы также почистили то, что передаётся в каждом вызове. После отключения инструментов, хуков, плагинов и MCP и установки собственного системного промпта накладные расходы на вызов модели снизились примерно с 9 000 входных токенов до 537, или около 950 при подключённой JSON-схеме. Это сокращение важно, потому что оно повторяется в каждом вызове и напрямую влияет на стоимость запросов к LLM.
Контракты, валидаторы и повторы с обратной связью
Контракт артефактов фиксирует имена файлов и JSON-схемы и проверяет их при каждой записи и чтении, так что форматы больше не могут расползаться. После каждой фазы модели запускается валидатор. Если проверка не пройдена, повторный запрос включает отчёт валидатора, и модель точно знает, что исправить.
Языки берутся только из брифа, без жёстко заданных списков, а продакшен переключается только после бенчмарка на тех же брифах. Откат задаётся значением в конфигурации: generation.mode принимает значение agent или script, а переключение требует одного значения и перезапуска воркера. Оба режима пишут одинаковые артефакты, поэтому статью, сгенерированную в одном режиме, можно исправить в другом.
Единый план ссылок для всех языков
Автор текста, переводчики и проверка используют один план перелинковки. Обычный код проверяет, есть ли каждая ссылка, не дублируется ли она, не выдумана ли и не ведёт ли на домен другого языка. Модель вызывается только при расхождениях и получает список несоответствий вместо всей задачи целиком.
До и после: как изменился рабочий процесс
Раньше множество агентов взаимодействовали в циклах с файлами, данными, поиском, кодом и настройками. Теперь процесс - прямая линия: подготовить данные, сгенерировать, проверить, опубликовать готовую статью. Бизнес-шаги остались прежними. Изменилось то, кто выполняет каждый шаг: код или модель.
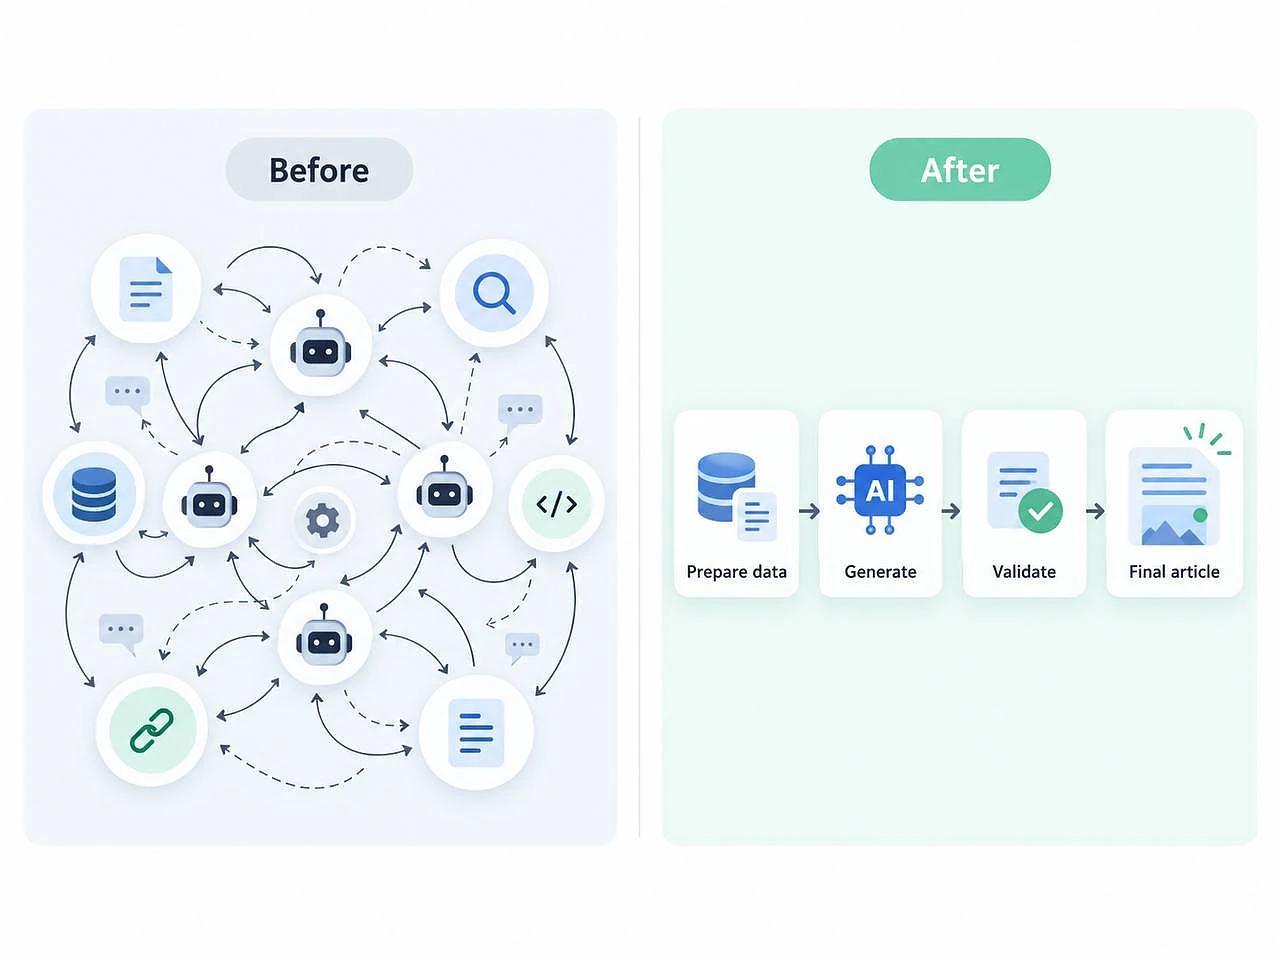
В таблице ниже сравниваются два режима на трёх брифах бенчмарка. Число вызовов инструментов в агентном режиме включает дополнительные сессии, которые действительно понадобились брифам A и B.
| Аспект | Агентный режим (до) | Скриптовый пайплайн (после) |
|---|---|---|
| Кто собирает данные | Субагенты читают файлы, вызывают API и пишут временные скрипты | Детерминированный код |
| Как передаётся контекст | Пути к файлам, которые модель должна открыть и перечитать | Фактическое содержимое в шаблонах промптов |
| Вызовы инструментов на статью (A/B/C) | 709 / 184 / 130 | 0 / 0 / 0 |
| Чтение из кэша на статью | 6-12 млн токенов | 3-31 тыс. токенов |
| Обработка ошибок | Агент импровизирует, перезапускает финальный скрипт, перезапускает воркеры | Отчёт валидатора, ограниченное число повторов, понятные причины остановки |
| Вставка ссылок | Отдельный агент-интерлинкер, часто одна ссылка за правку | Автор следует общему плану; код проверяет результат |
Выходные токены, то есть полезный текст, изменились гораздо меньше, чем чтение из кэша. Это подтверждает, где были потери: в навигации и повторном чтении, тогда как объём самого текста остался примерно прежним.
Интерлинкер делает разницу осязаемой. В агентном режиме он стоил в среднем $4,52 за запуск. В скриптовом режиме на всех трёх брифах он обошёлся в $0: автор вставил все запланированные ссылки, и проверка кодом прошла вообще без вызова модели.
Одно исключение мы сделали сознательно. Правки, запрашиваемые из CMS, остались в агентном режиме. Когда редактор просит заменить термин по всей статье, скриптовый маршрут должен вернуть весь текст целиком, а это стоит примерно как перевод. Точечные правки агента здесь сопоставимы по цене или дешевле, поэтому мы оставили инструмент, который подходит под задачу.
Результаты на тех же реальных задачах
На трёх реальных продакшен-брифах скриптовый пайплайн обошёлся в $35,13 в эквиваленте вместо $95,32 (в 2,71 раза дешевле) и занял 36,8 минуты вместо 94,2 (в 2,56 раза быстрее). Число вызовов модели снизилось с 197/163/117 до 13/10/6. С учётом перезапусков, которые реально понадобились агентному режиму, разница достигла 4,86 раза по стоимости и 4,40 раза по времени.
Мы выбрали брифы с разными конфигурациями. Бриф A охватывал en/de/ru, развёрнутый формат, со всеми необязательными фазами. Бриф B охватывал ru/en/de, длинный формат, только с ключевыми словами. Бриф C охватывал en/ru, средняя длина, без необязательных фаз. Данные по агентам взяты из существующих продакшен-транскриптов. Скриптовые запуски шли через replay-бэкенд, который читает из продакшена, но ничего в него не пишет, а оба режима использовали одну и ту же таблицу цен. Брифы A, B и C мы оставляем анонимными.
Стоимость: с $95,32 до $35,13 в эквиваленте
По брифам, при сравнении медианного агентного запуска со скриптовым, цифры такие:
- Бриф A: $44,49 против $18,77;
- Бриф B: $29,96 против $12,11;
- Бриф C: $20,87 против $4,25.
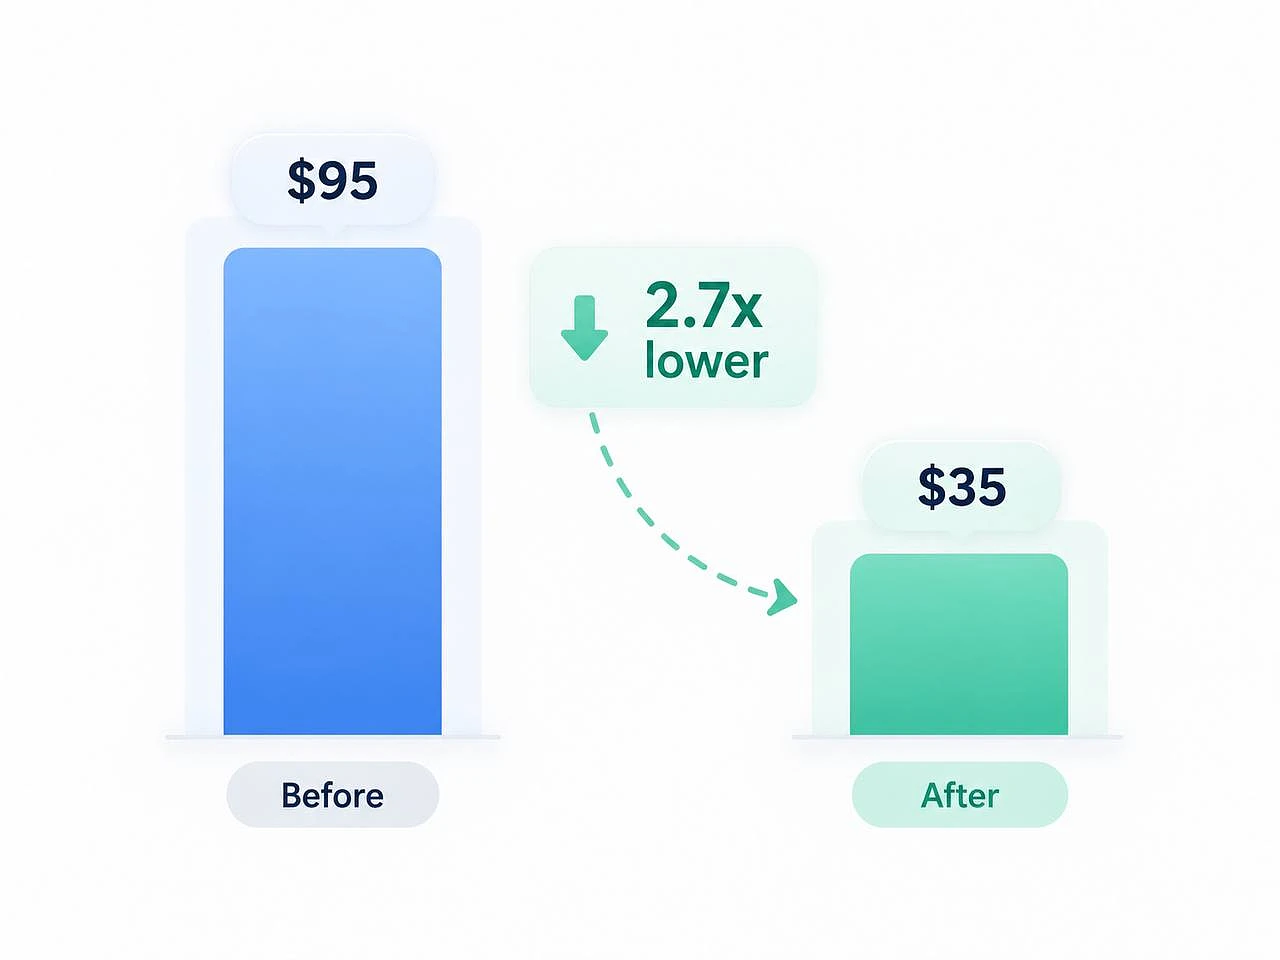
Это эквиваленты по публичным тарифам моделей, тогда как проект работает по подписке. Они измеряют расход ресурсов, и воспринимать их как буквальный счёт не стоит. Повторы после валидации составили около 29% стоимости скриптового режима, или $10,3. Без них, по нашей оценке, три брифа обошлись бы примерно в $24,9, но это оценка, отдельно она не измерялась.
Время: с 94,2 до 36,8 минуты
Время сократилось на каждом брифе, а наибольший относительный выигрыш пришёлся на самый простой:
- Бриф A: 38,2 против 19,1 минуты;
- Бриф B: 34,2 против 13,1 минуты;
- Бриф C: 21,8 против 4,6 минуты.
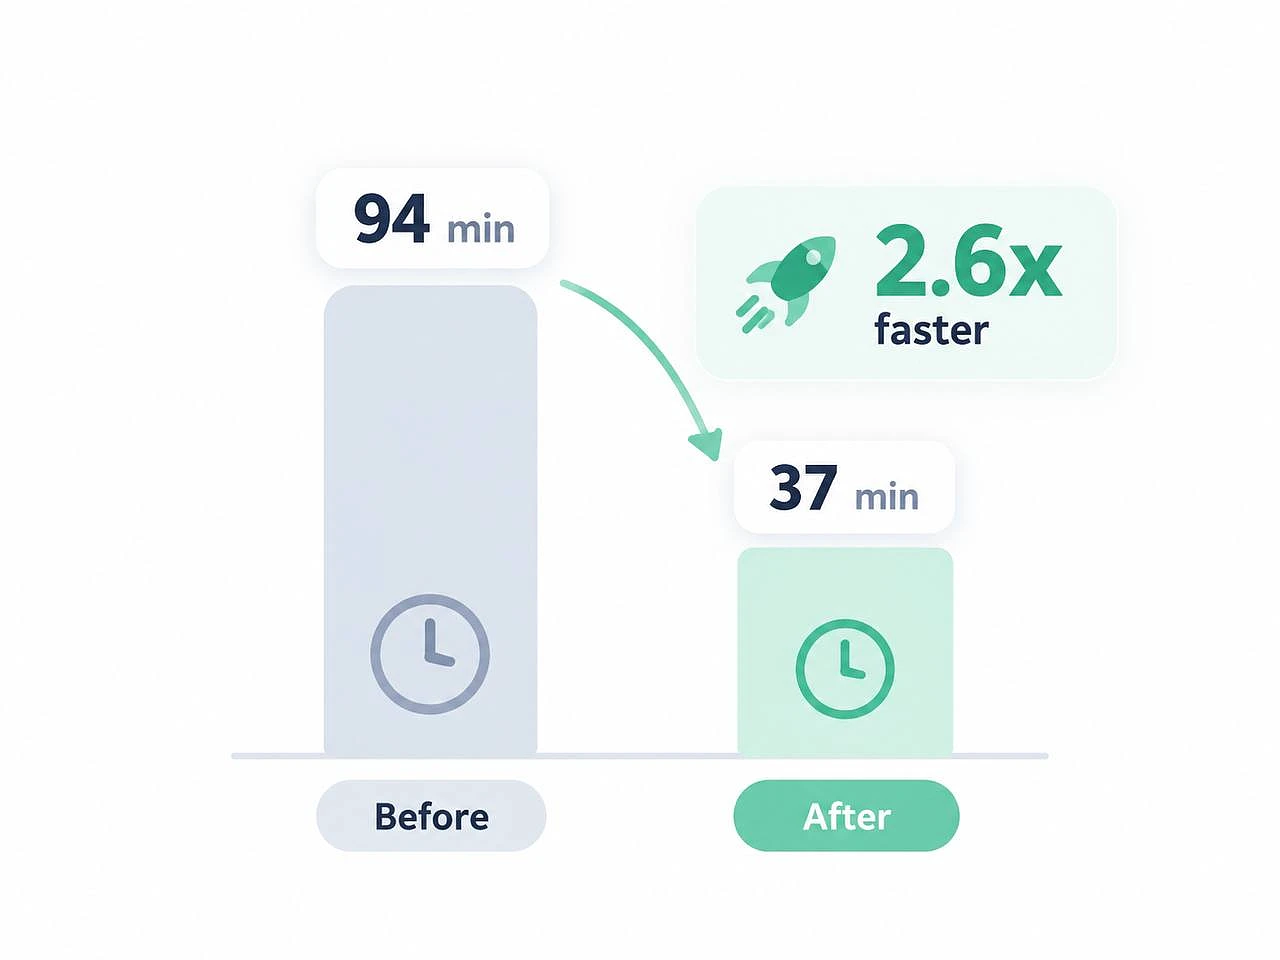
На графике измеренные итоги округлены до 94 и 37 минут. Ускорение в 2,6 раза описывает наш пайплайн на этих брифах, и выдавать его за универсальный результат для ИИ-проектов мы бы не стали. Ваш выигрыш зависит от того, сколько рутинной работы текущая схема отдаёт модели.
Вызовы модели и перезапуски, которые никто не закладывает в бюджет
Число вызовов модели на бриф снизилось с 197/163/117 в агентном режиме до 13/10/6 в скриптовом. Меньше вызовов означает меньше повторного чтения, меньше мест для ошибок окружения и более короткий путь к готовой статье.
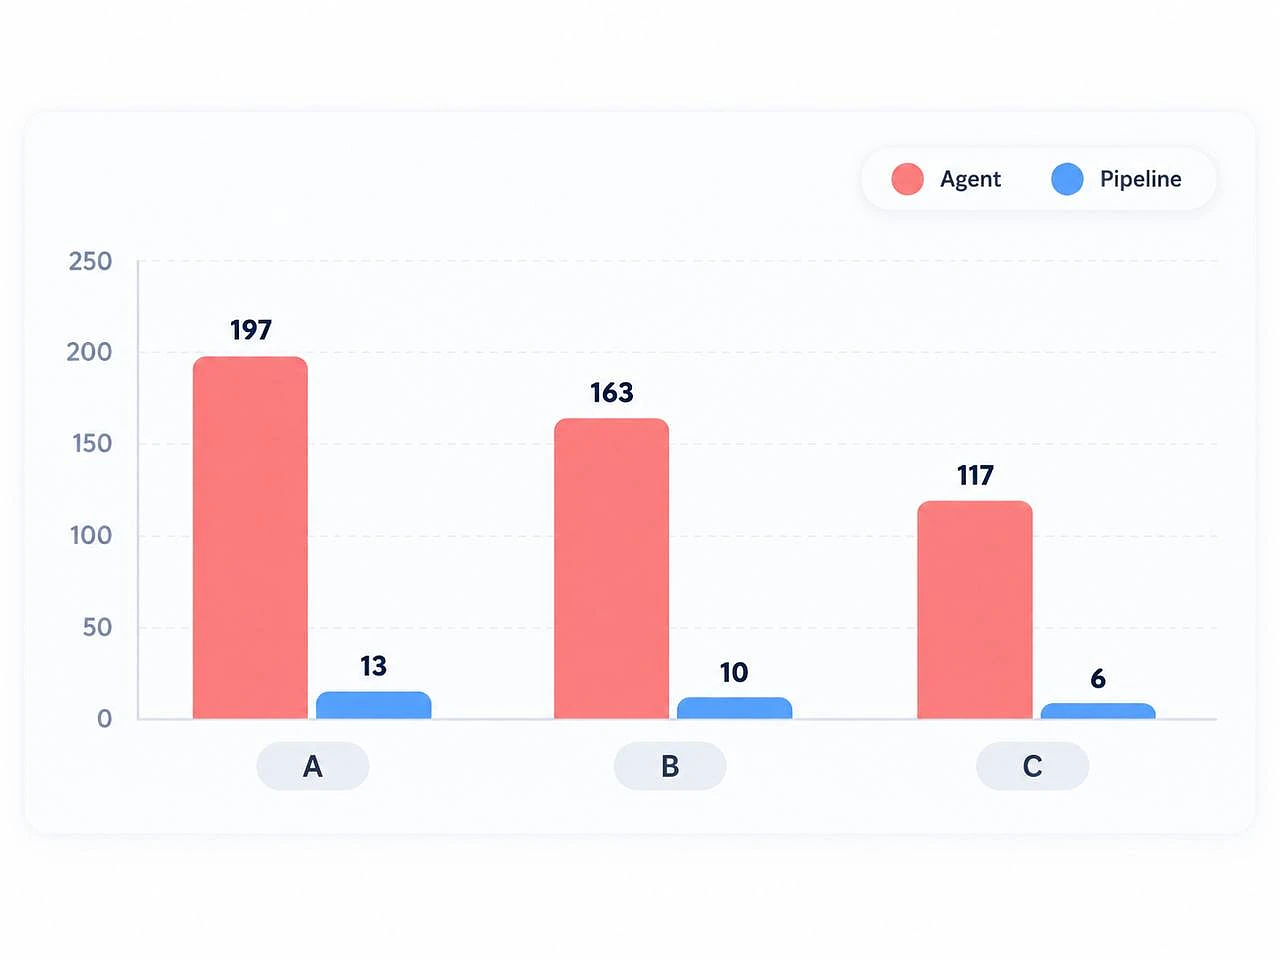
Медианные запуски скрывают то, что сильнее всего бьёт по бюджету. Брифу A для завершения на самом деле понадобились три агентные сессии: $119,23, 105,2 минуты и 593 вызова модели. Наш лучший случай, бриф C, в скриптовом режиме оказался в 4,91 раза дешевле и в 4,72 раза быстрее.
Финальный шаг говорит о том же. Агентному режиму понадобилось 8 перезапусков скрипта и 2 перезапуска воркера для брифа A, 10 перезапусков для брифа B и 1 для брифа C. Скриптовому режиму не понадобилось ни одного. Каждый перезапуск стоит ещё и чьего-то внимания: человек должен заметить сбой, перезапустить задачу и снова проверить результат.
Планируя бюджет ИИ-процесса, учитывайте перезапуски. План, построенный на запуске без сбоев, хорошо выглядит в пилоте и не отражает реальную стоимость в продакшене.
Надёжность выросла вместе со снижением затрат
Более дешёвый пайплайн оказался и более надёжным. Все скриптовые версии прошли финальную проверку перед публикацией и содержали 100% запланированных внутренних ссылок. Детерминированные проверки также нашли дефекты, которые агентная схема пропустила в уже опубликованные статьи.
Стоимость и надёжность здесь не конкурировали друг с другом. Обе улучшились по одной причине: рутинная работа перестала зависеть от модели, а значит, перестала зависеть от её импровизации.
Дефекты в уже опубликованных статьях
Мы прогнали новую проверку ссылок по 23 опубликованным статьям. Она нашла 3 случая, когда ссылка из отчёта о перелинковке отсутствовала в тексте, 2 дублирующиеся ссылки на одну и ту же страницу и 23 URL за пределами запланированного набора страниц. Кроме того, в 4 статьях из 30 наборы страниц различались между языками.
Две находки выделялись особо. В одной статье английская и русская версии ссылались на страницу на немецком домене. В другой отчёт о перелинковке не совпадал с фактическим текстом, то есть агент отчитался о работе, которую не выполнял.
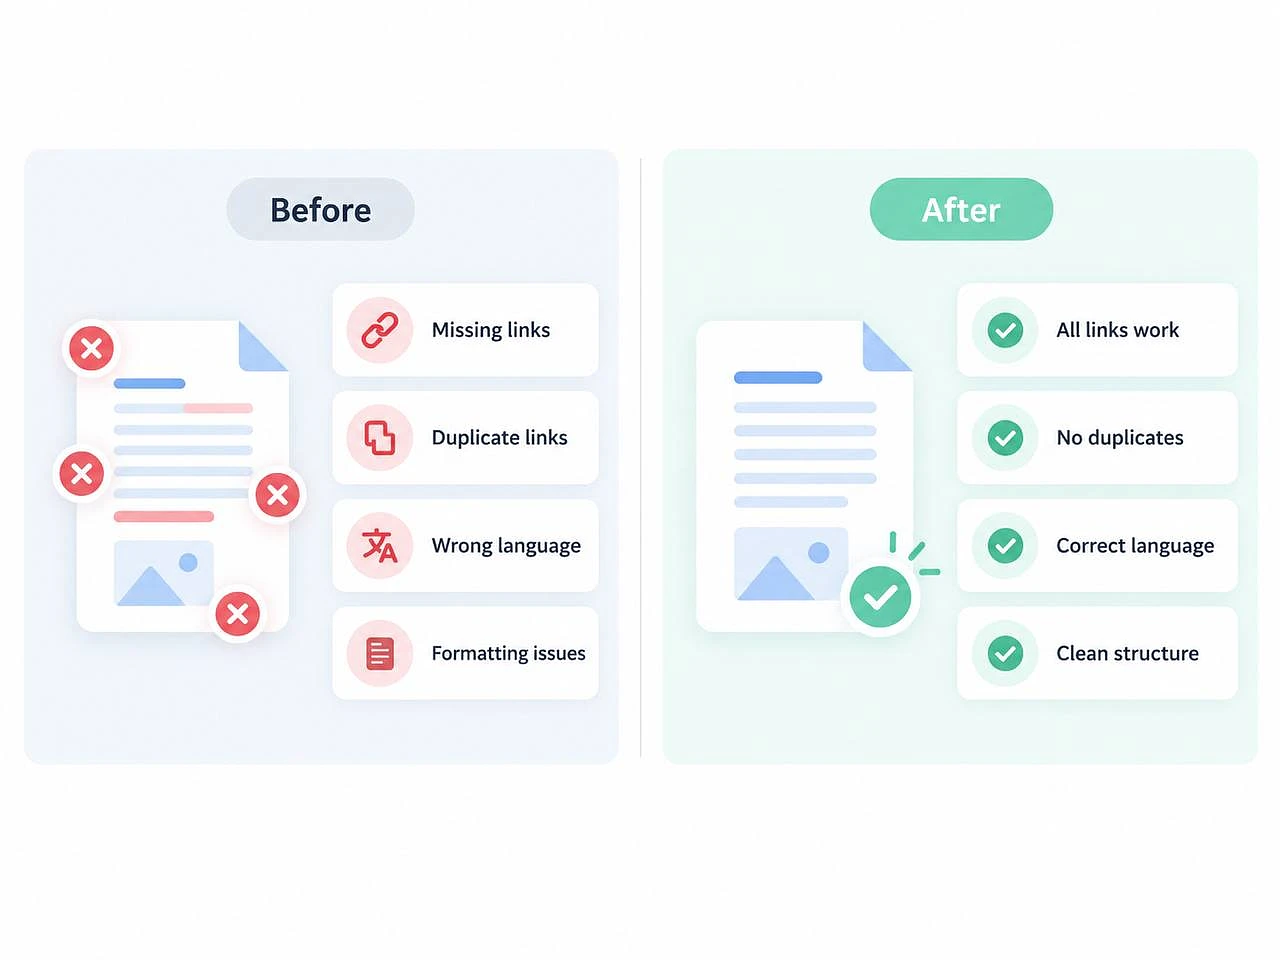
Иллюстрация показывает типы дефектов и ничего не говорит об их частоте. Для многоязычного сайта такие ошибки обходятся дорого: ссылка на другой язык ломает путь пользователя, который тщательно продумывает хороший дизайн сайта, а пропущенная ссылка ослабляет структуру страниц, на которую опираются поисковые системы.
Правила самовосстановления и сценарии сбоев
Надёжность нового пайплайна обеспечивают явные правила, которые мы записали до того, как что-то сломалось:
- неудачная валидация запускает повтор с отчётом валидатора, не более двух раз;
- при недоступности внешней системы используется резервный источник;
- сбой некритичной фазы записывает пустой артефакт, соответствующий схеме, и генерация продолжается;
- сбой критичной фазы (текст, перевод, загрузка) останавливает запуск с понятной причиной;
- ошибки бэкенда 5xx получают 3 повтора, а конфликт slug с кодом 409 не повторяется.
Мы проверили эти правила в сценариях сбоев. При недоступном поисковом провайдере генерация продолжилась, а ошибка была записана в лог и классифицирована. Когда мы удалили запланированную ссылку из немецкой версии, один корректирующий инференс восстановил её с первой попытки.
Один сценарий выявил наш собственный дефект. Перезапуск только немецкого перевода не затронул другие языки, но метаданные и FAQ пересчитались для всех языков. Мы это исправили. Находить такие вещи в контролируемом тесте - именно поэтому мы проводим бенчмарк до переключения продакшена.
Что это значит для внедрения ИИ в бизнес
Урок выходит за рамки контента. В любом бизнес-процессе, включая интеграцию с ERP и интеграцию с CRM, модель должна отвечать только за шаги, требующие суждения или работы с языком. Получение данных, вызовы API, проверки, запись в учётные системы и маршрутизация должны быть детерминированными, измеримыми и легко откатываемыми.
Внешние исследования указывают в похожем направлении. Исследование MIT Sloan о том, как ИИ меняет рабочие процессы, утверждает, что наибольшую ценность даёт перестройка процессов целиком, а каждая передача работы добавляет затраты на координацию, такие как проверка и валидация. Там фокус на выстраивании цепочек задач для ИИ, у нас - на разделении работы модели и кода, но в обоих случаях ИИ оценивается по эффективности всего процесса. Google Cloud описывает переход от ассистентов к агентным командам и тенденцию надстраивать интерфейсы на естественном языке над унаследованными системами, например над инсталляциями SAP возрастом в десятки лет. Именно на этом слое детерминированная интеграционная работа решает, будет ли ИИ надёжным.
Агенты - инструмент, а не архитектура по умолчанию
Наша позиция прямая: используйте агентов, когда задача требует открытого исследования, а всё остальное проектируйте как пайплайн. Агент ценен, когда путь к ответу неизвестен. Когда путь известен, код проходит его быстрее, дешевле и с меньшим количеством сюрпризов.
Андрей Попов, CTO и основатель Webdelo, формулирует редакционную позицию команды по итогам этого проекта:
Агентное поведение - это инструмент, который мы выбираем под конкретную задачу. Наш собственный пайплайн показал, что основная часть затрат приходилась на то, что агенты перечитывали контекст и боролись с окружением, а само написание текста занимало небольшую долю. Мы отдаём модели работу, которая требует смысла, а данные, API, проверки и маршрутизацию делаем детерминированными, измеримыми и обратимыми.
Андрей Попов, CTO и основатель, Webdelo
В нашем кейсе есть и контрпример. Правки из CMS остаются агентными, потому что правка всего текста в скриптовом режиме стоит дороже: $6,75 против $5,12. Дефекты генерации, напротив, код находит за секунды. Мы выбираем под каждую задачу, опираясь на измерения.
Вопросы перед масштабированием автоматизации с ИИ
Прежде чем масштабировать ИИ-процесс, предлагаем вашей команде ответить на эти вопросы с опорой на данные:
- Где модели действительно нужен смысл, а где она выполняет рутину, которую мог бы делать код?
- Сколько стоит одна единица процесса с учётом перезапусков и ручных рестартов?
- Как качество проверяется машиной до того, как результат попадёт к клиенту или в учётную запись?
- Реальны ли и работают ли интеграции с вашими ERP, CRM и внутренними API, или ИИ прикрывает сломанные данные выдуманным результатом?
- Есть ли бенчмарк на тех же реальных задачах и переключатель отката до изменений в продакшене?
- Проверял ли кто-нибудь саму методику измерений, как в случае с дублирующимися строками транскрипта, которые удвоили нашу первую оценку затрат?
Рост расходов на ИИ становится управленческой темой, что показывает анализ McKinsey о том, как CIO могут управлять спросом на ИИ в масштабе. Вопросы выше превращают эту тему в конкретные проверки для отдельного процесса.
Ограничения кейса и что мы проверим дальше
Это небольшой честный бенчмарк, и ничего универсального он не доказывает. Он охватывал 3 брифа блогового типа и 7 правок, использовал долларовые эквиваленты вместо счетов и полагался на оценку качества моделью, а не редактором-человеком. После устранения недостатков, выявленных бенчмарком, повторных замеров мы ещё не проводили.
Свою же строгую цель "в 4 раза дешевле" на отдельном запуске мы тоже не достигли: получилось 2,7 раза на запуск и 4,9 раза на фактическую статью с учётом перезапусков. На момент измерений первая скриптовая генерация через продакшен-воркер ещё не запускалась.
Где скриптовая версия уступила
Модель оценивала черновики вслепую, как A/B, по редакторскому чек-листу из пяти критериев. Скриптовая версия выиграла на брифе C (4,1 против 3,7) и проиграла на брифе A (3,6 против 3,9) и брифе B (3,2 против 4,0). Проигрыш в двух сравнениях из трёх сказал нам, что в таком виде пайплайн ещё не готов.
Мы нашли и устранили конкретные причины:
- служебная фраза модели попала в текст статьи;
- FAQ игнорировал вопросы, перечисленные в брифе;
- текст получился на 38% короче агентной версии;
- в русской версии отсутствовало точное ключевое слово;
- все источники исследования попадали в самый низкий уровень авторитетности;
- запросы на правку с ответом "исправлять нечего" уходили в дорогой агентный режим.
Повторы после валидации также съедали около 29% стоимости скриптового режима, и это следующая очевидная цель.
Что мы проверим дальше
Следующие шаги прямо вытекают из перечисленных ограничений:
- повторить бенчмарк после исправлений на тех же брифах, а затем на других типах контента;
- добавить оценку редактором-человеком наряду с оценкой моделью;
- отслеживать фактические лимиты использования и стоимость продакшен-запусков в скриптовом режиме на длительном отрезке;
- сократить число повторов после валидации и найти более дешёвый способ правки всего текста.
Другие типы контента важны, потому что статьи для блога - лишь часть того, что производит платформа. Отраслевые страницы имеют другую структуру и более строгие требования, например страницы про разработку сайтов недвижимости, разработку сайта по ремонту техники или разработку сайтов красоты. Мы опубликуем только то, что подтвердят измерения.
Как спланировать оптимизацию ИИ-процессов в вашей компании
Если ваша автоматизация с ИИ работает, но она дорогая, медленная или ей сложно доверять, решение обычно кроется в архитектуре, а более крупная модель помогает редко. Тот же метод мы применяем к процессам клиентов: сначала измерить, отделить работу модели от рутинного кода, внедрить валидацию и сравнить на реальных задачах до масштабирования.
Для B2B-компаний среднего размера, в России и за её пределами, такая оптимизация ИИ-процессов обычно означает работу с системами, на которых уже держится бизнес. Данные о заказах хранятся в ERP, история клиентов - в CRM, а контент питает сайт и интернет маркетинг. ИИ должен встроиться в этот ландшафт с понятными входными данными, проверками и возможностью отката.
Обсудите ваш ИИ-процесс с нашей командой: мы поможем оценить процесс, спроектировать архитектуру, интегрировать ИИ с вашими ERP/CRM или внутренними системами и измерить экономику до масштабирования. Типичный проект включает:
- Аудит процесса: где модель добавляет смысл, где выполняет рутину и сколько на самом деле стоит одна единица с учётом перезапусков.
- Архитектура ИИ-ассистента или агента: решение, в котором агенты используются только там, где нужно исследование, а везде остальное работают детерминированные шаги.
- Интеграция с ERP/CRM: рабочие подключения к вашим данным и API, чтобы модели никогда не приходилось угадывать.
- Бенчмарк стоимости и надёжности: сравнение на ваших реальных задачах с планом отката до выхода в продакшен.
Когда процесс затрагивает клиентские системы, наша команда, отвечающая за разработку сайтов, строит интеграционный слой с той же дисциплиной контрактов, валидаторов и измеряемых релизов. Бюджет всегда обсуждается индивидуально, после того как мы разберёмся в процессе.
Главные выводы после перестройки пайплайна
Наш ИИ-процесс стал дешевле и надёжнее, как только мы перестали поручать агентам рутинную работу. На тех же трёх брифах стоимость снизилась в 2,71 раза, а время - в 2,56 раза, и до 4,86 и 4,40 раза с учётом реальных перезапусков. Детерминированные проверки к тому же выявили дефекты в уже опубликованных статьях.
Основные уроки, которые мы вынесли из перестройки:
- Затраты создавало окружение. Агенты перечитывали контекст и боролись с путями к файлам, подписями и разбором ответов, и в нашей схеме на каждый написанный токен приходилось около 63 прочитанных. Цена модели была второстепенным фактором, а дорогая модель даже не работала.
- Агенты - это инструмент. Модель отвечает за смысл: написание, перевод, синтез. Код отвечает за данные, API, проверки, запись в системы и маршрутизацию.
- Надёжность следует за структурой. Контракты, валидаторы, повторы с обратной связью и единый план ссылок сделали качество измеримым и воспроизводимым.
- Измерения тоже нужно проверять. Дублирующиеся строки транскрипта удвоили нашу первую оценку, а исправление методики изменило абсолютные цифры.
- Ограничения остаются на виду. Мы сообщаем о долларовых эквивалентах, небольшой выборке, оценке моделью и брифах, где скриптовая версия проиграла, и держим переключатель отката в конфигурации.
Эти принципы применимы далеко за пределами контента. Любой процесс, связывающий ИИ с ERP, CRM или внутренними API, выигрывает от того же разделения на суждение и детерминированную работу, а также от бенчмарка на реальных задачах до какого-либо масштабирования.
Если вы планируете автоматизацию бизнес-процессов с помощью ИИ или ваша текущая автоматизация обходится дороже, чем должна, обратитесь к нашей команде. Мы оценим процесс, спроектируем архитектуру, интегрируем ИИ с вашими ERP/CRM или внутренними системами и вместе с вами измерим экономику до масштабирования.
