

Service Level Objectives — измеримые цели качества сервиса
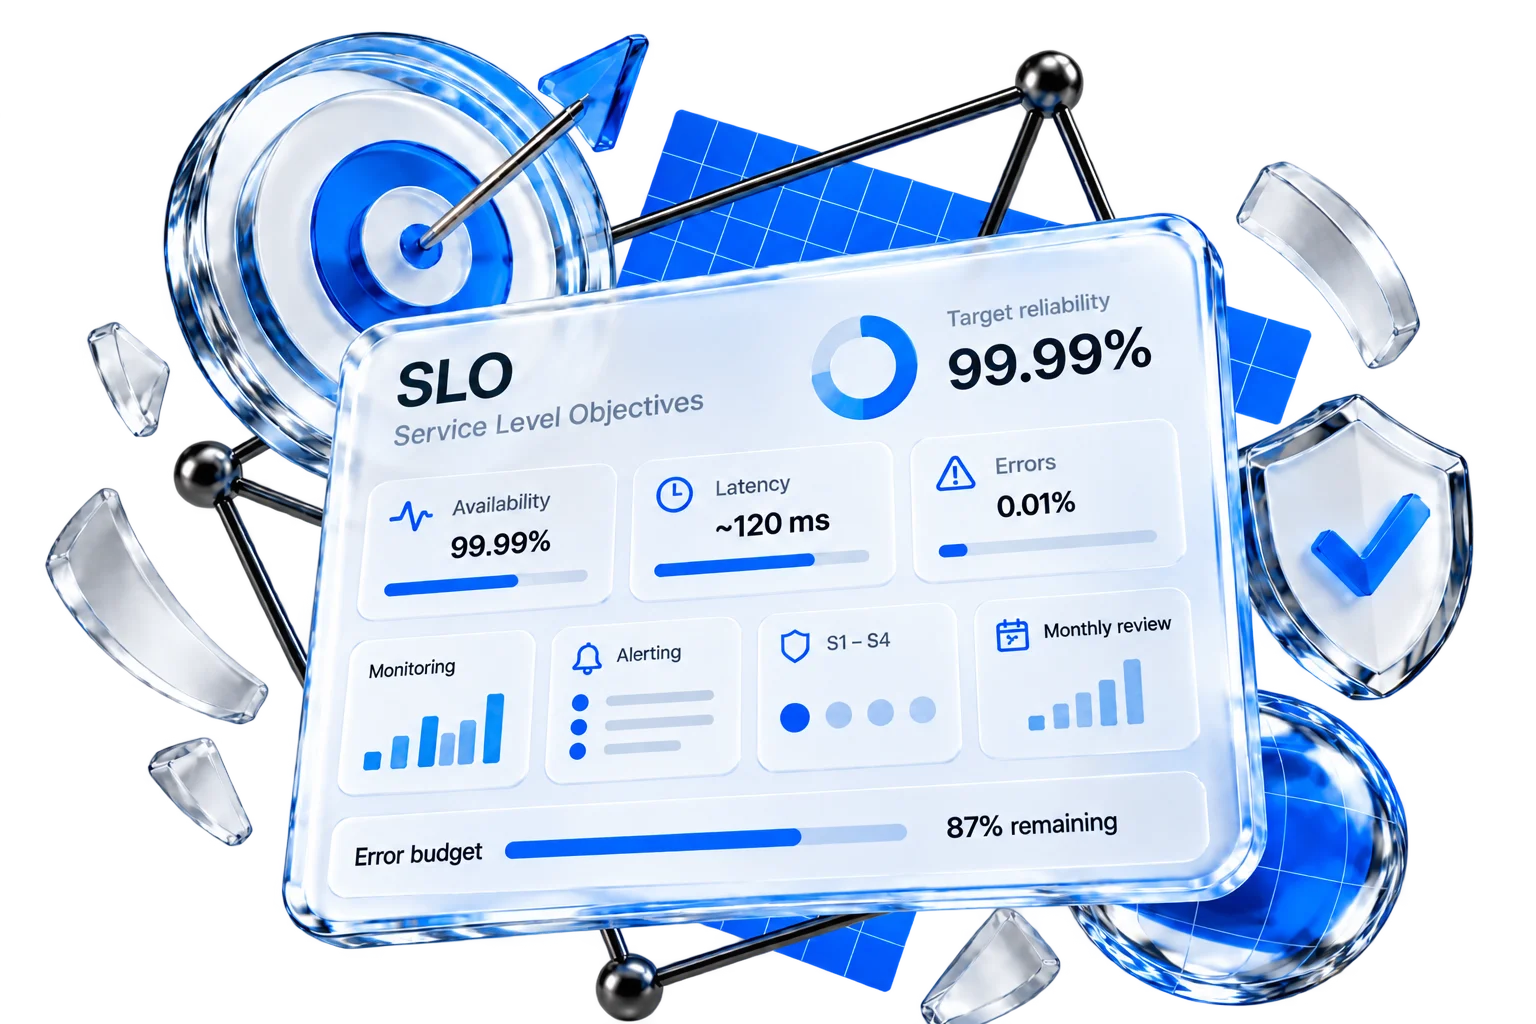
SLO — целевые значения SLI, которые Webdelo обязуется поддерживать на проектах сопровождения. Конкретные цифры всегда фиксируются в SOW после аудита: универсальных «99.99% на всё» мы не обещаем. Стандартный пакет включает многослойный мониторинг, alerting, S1–S4 модель реагирования, error budget и регулярную отчётность.
 Цели — после аудита, в SOW
 SLI: availability · latency · errors
 S1–S4 incident model
 Monthly service review
 Grafana · Prometheus · VictoriaMetrics
 Error budget policy
Ключевые факты (answer-first)
SLO — операционные цели, не контрактные обязательства. Конкретные значения всегда определяются после аудита и фиксируются в SOW. Универсальных uptime-чисел мы не публикуем — таргеты всегда привязаны к проекту, его архитектуре, тиру сервиса и бюджету поддержки.
SLI-категорий в стандартном пакете
модель severity для инцидентов
acknowledge для S1 (индикативно)
стандартная cadence service review

Цели — после аудита
Без аудита SLO не назначаются. Реалистичные таргеты — после анализа архитектуры, нагрузки и tier'ов.

SOW
Конкретные значения SLO, error budget'ы, response times и cadence отчётности — приложение к договору.

Grafana · Prometheus · VictoriaMetrics
Базовый стек. Альтернативы (Datadog, NewRelic и др.) — по согласованию с клиентом.

Три разные сущности
SLI — метрика. SLO — таргет на метрику. SLA — контракт. SLO живёт в SOW; SLA — отдельный документ.

Управляет приоритетами
Когда бюджет исчерпан — feature work останавливается, команда переходит на reliability.

Zero incidents · 24/7 by default
Минимизируем влияние инцидентов; круглосуточное покрытие — по тарифу и tier'у сервиса.
Терминология: SLI · SLO · SLA · SOW · Error budget
Базовый словарь, которым мы пользуемся в обсуждении и документах. SLI — то, что измеряется. SLO — целевое значение этой метрики. SLA — юридический документ. SOW — техническая спецификация, где фиксируются конкретные цифры.

 Error budget
Область действия: что покрывается, что — нет
SLO применимы к системам и слоям, которые мы наблюдаем и контролируем. Внешние сервисы, плановые окна обслуживания и форс-мажорные события — за пределами наших целей по умолчанию.
 В области действия

Web-приложения и API с определёнными service tier'ами
Микросервисная архитектура и распределённые системы
Высоконагруженные аналитические платформы и data pipelines
Финансовые и торговые системы, internal fintech/banking-инструменты
Marketing automation и ERP-модули
Инфраструктурный слой: серверы, контейнеры, БД, network services
 Вне области действия

Third-party сервисы и API вне нашего или клиентского контроля (платёжные шлюзы, внешние провайдеры)
Плановые окна обслуживания, согласованные заранее
Деградации, вызванные изменениями со стороны клиента вне согласованного change-management процесса
Форс-мажорные события вне разумных технических средств контроля
Что определяет параметры SLO
SLO-таргеты формируются под три основных фактора. Их комбинация определяет, как глубоко покрыт мониторинг, насколько строгие пороги и кто и как реагирует.

Архитектурная сложность
Монолит на одной БД и распределённая система из 20 сервисов требуют принципиально разных подходов к мониторингу. Чем сложнее — тем больше точек наблюдения и шире on-call.

Tier сервиса
Не все компоненты несут одинаковый бизнес-вес. Платёжный шлюз и сервис генерации внутренних отчётов имеют разные требования к response. Tier определяет приоритет, time-to-respond и состав on-call.

Бюджет поддержки
Бюджет определяет число специалистов, режим работы (рабочие часы / extended / 24×7) и глубину мониторинга бизнес-метрик.
Когда устанавливаются SLO
Есть две точки входа. Идеальный сценарий — мониторинг встроен в архитектуру с самого начала. На существующих проектах observability достраивается постепенно после аудита.

Новые сервисы
Мониторинг и метрики закладываются в архитектуру с самого начала. К моменту запуска полное observability-покрытие уже на месте — идеальный сценарий.

Onboarding на существующий проект
Webdelo проводит аудит инфраструктуры, определяет tier'ы сервисов, выявляет пробелы в мониторинге и достраивает observability итеративно. Конкретные SLO фиксируются в SOW по итогам аудита.
В обоих сценариях для ключевых метрик определяются error budget'ы — они становятся инструментом приоритизации между разработкой фич и работами по стабильности.
SLI: что мы измеряем
Семь категорий измерений, которые покрывает стандартный пакет. Конкретные пороги — индивидуально, но категории и подход неизменны.
 Availability
 Errors
 Latency
 Resources
 Databases
 Network endpoints
 Business metrics

Реальный кейс — мониторинг бизнес-метрик


На одном из проектов был настроен мониторинг времени переходов между статусами заказа. Метрики показали, что часть заказов «застревает» на конкретных стадиях обработки. Расследование вскрыло составной отказ: misfire в support confirmation flow + спайки latency у внешнего delivery API = накопление зависших заказов = перегрузка БД = деградация всей системы. Каждый компонент в изоляции выглядел здоровым; каскад был виден только через бизнес-метрики.
Стандартный SLO-пакет: пять компонентов
Каждое engagement по поддержке Webdelo включает пять обязательных компонентов. Конкретные инструменты и пороги — настраиваются.

Monitoring infrastructure. Базовый стек — Grafana + Prometheus (или согласованные эквиваленты). Покрытие охватывает все семь SLI-категорий: availability, errors, latency, resources, databases, network dependencies, business processes.

Alerting system. Реализуется на VictoriaMetrics или эквиваленте. Каждый алерт привязан к конкретному порогу метрики и уровню severity. Доставка — в командный мессенджер (Slack, Telegram или согласованный канал). On-call инженеры получают только actionable-сигналы; low-priority шум фильтруется.

Runbooks и пути эскалации. Для каждого сервиса ведётся карта ответственности: кому идёт алерт, порядок эскалации и шаги первого реагирования до подключения профильного специалиста. Это устраняет задержку «кто за это отвечает?» в момент инцидента.

Команда incident management. Работает на трёх уровнях: incident management — специалисты с полным знанием архитектуры, открывают инциденты, заводят тикеты в Jira/ClickUp/системе клиента, назначают владельцев; on‑call DevOps/SysOps — диагностика на уровне серверов, контейнеров, сети, оркестрации; on‑call developers — подключаются, когда проблема локализована в коде или бизнес-логике.

Канал user-reported issues. Канал для сотрудников клиента, чтобы сообщать о замеченных аномалиях. Конечные пользователи часто видят проблемы раньше, чем срабатывают автоматические алерты. Все сообщения консолидируются, триажируются и попадают в стандартный incident-workflow.
Incident Severity Model — S1–S4
Четырёхуровневая модель критичности. Указанные времена — индикативные; финальные параметры зависят от tier'а сервиса, режима on-call и бюджета и фиксируются в SOW.

Конкретные значения зависят от tier'а сервиса, режима on-call и бюджета. Финальные параметры фиксируются в SOW.
Error Budget Policy
Error budget — допустимый объём деградации сервиса в пределах периода измерения (обычно месяц или квартал). Состояние бюджета напрямую определяет, на что команда тратит время — на фичи или на стабильность.
Бюджет в норме
Остаток выше порога предупреждения. Команда работает в стандартном темпе: разработка фич и инфраструктурные изменения идут как обычно.
Бюджет на грани
Остаток ниже порога предупреждения. Приоритеты сдвигаются на стабильность. Новые фичи паузятся, пока бюджет не восстановится — или пока SLO не будет пересмотрен с клиентом.
Бюджет исчерпан
Работа над фичами останавливается полностью. Команда фокусируется только на восстановлении надёжности. Совместный с клиентом review — root cause и обновлённый план.
Отчётность и service reviews
Регулярная отчётность даёт клиенту прозрачность по SLI, состоянию error budget и тренду надёжности. Стандартная cadence — месяц; недельный или квартальный формат — по согласованию.
Состав периодического отчёта
SLO status
Error budget
 Incidents
 Trends
 Recommendations

Post-incident process
Каждый инцидент порождает задачу с описанием root cause, затронутых систем и предпринятых шагов. К ней линкуются bug-fix и logic-correction тикеты. Получившийся кластер задач — основание для postmortem-ревью и долгосрочного анализа эффективности команды.
Cadence
регулярный service review
для high-tier систем
QBR-формат
Чего мы не обещаем
Чёткие границы возможностей — часть того, как Webdelo выстраивает доверие. Лучше прямо назвать, где наши гарантии заканчиваются, чем подписаться под цифрами, которых не сможем выдержать.

Не публикуем «99.99% на всё»
Никаких единых цифр до аудита. Таргеты всегда привязаны к проекту.
Внешние зависимости вне контроля
Мониторим внешние API и сервисы, но не можем гарантировать их доступность.
SLO — операционная цель
Юридические последствия за нарушения определяет отдельный SLA.
24/7 — не по умолчанию
Круглосуточный on-call зависит от бюджета и tier'а. Стандартный пакет — расширенные рабочие часы.
Zero incidents — не гарантируется
Работаем над предотвращением и снижением влияния. Полное отсутствие инцидентов не обещаем.
Требуют отдельного scope
Мониторинг бизнес-процессов согласуется отдельно: какие метрики, какие данные доступны.
Итог
Подход команды Webdelo к SLO — это инженерная практика, а не маркетинговые обещания. Мы определяем, что именно измерять, настраиваем инструменты, формируем команду и согласовываем реалистичные целевые показатели. Конкретные значения SLO фиксируются в SOW после аудита. Это позволяет нам брать на себя ответственность за результат, а заказчику — понимать, что именно ему гарантируется.
Если вас интересует сопровождение вашего проекта — свяжитесь с нами для обсуждения.
