


Почему быстрый прототип ещё не означает готовую систему
С 2006 года мы в Webdelo создаём сложные корпоративные B2B-системы, включая FinTech, торговые платформы и ERP. Я Андрей Попов, CTO Webdelo. Для нас ai first разработка означает, что агенты пишут код, а инженеры управляют работой и принимают результат. Быстрый прототип ещё не означает, что системе можно доверить деньги.
На нашей платформе для алгоритмической торговли ошибка может привести к потере средств или повторному ордеру - заявке на покупку или продажу. Поэтому независимая проверка кода и тесты обязательны. Но журналы работы показали другую проблему: 59 % входных токенов агенты потратили на ожидание.
Когда заказчик обсуждает с нами разработку сайтов или дизайн сайта для сложного продукта, я сначала уточняю, какие операции будет выполнять система. В этом проекте основной риск находился внутри: в учёте средств и обработке торговых заявок.
AI-агент - программа, которая обращается к модели и использует инструменты для выполнения задания. У нас агент-координатор распределял работу между тремя-четырьмя авторами кода. Агенты-ревьюеры проверяли изменения, а люди принимали архитектурные решения и проводили приёмку.
Для понимания цифр достаточно трёх терминов:
- Токен - небольшой фрагмент текста, которым измеряется объём информации для модели.
- PR, или pull request - набор изменений, предложенный для включения в основную версию кода. Слитый PR означает, что изменения включены.
- Ревью - проверка изменений другим участником процесса.
Сколько токенов тратили агенты и что они читали
За 5-9 октября 2026 года мы насчитали 276 сессий Codex, 25 827 запросов к моделям и 3,25 млрд входных токенов. За это время в основную версию кода вошли 94 PR. При этом 97,4 % входа составлял кэшированный контекст - уже переданная информация, которую модель обрабатывала повторно.
Контекст - это доступная модели история работы: инструкции, сообщения и результаты команд. В нашем процессе один запрос в среднем содержал 126 тыс. входных токенов, а ответ - около 600. Написанный код и размышления модели вместе составляли меньше процента от объёма входа.
Повторный, кэшированный контекст 97,4 %
Новая информация 2,6 %
Источник: журналы Webdelo. Диаграмма показывает только вход модели, без её ответов.
Для меня это свелось к простой формуле: расход входных токенов = число запросов × средний размер контекста. Оптимизация расхода токенов должна уменьшать число лишних обращений и объём истории в каждом из них.
Почему агенты ждали вместо того, чтобы работать
Около 1,9 млрд входных токенов, или 59 % всего входа, ушло на ожидание и опрос состояния. Агент спрашивал: "Тесты уже прошли?" или "Исполнитель ответил?" Каждый такой вопрос снова отправлял модели накопленный контекст.
В нашей конфигурации инструмент возвращал управление модели не позднее чем через 300 секунд. Полная проверка занимала 15-23 минуты. За одну проверку модель просыпалась три-пять раз, а координатор реагировал даже на служебное сообщение исполнителя "я жив".
Одновременно возникали длинные паузы между полезными действиями. Координатор мог ждать напоминания полчаса, хотя ревьюер заканчивал за 5-15 минут. За контрольные сутки мы насчитали 11,6 часа такого простоя.
Координатор Исполнители
5 октября 69 % / 57 %
6 октября 61 % / 59 %
7 октября 77 % / 60 %
8 октября 58 % / 45 %
9 октября 71 % / 51 %
Источник: журналы Webdelo. Здесь сравниваются запросы, а показатель 59 % выше относится к входным токенам.
Ожидание занимало значительную часть обращений у обеих ролей. В эту категорию входило и необходимое ожидание собственных тестов. Проблемой было повторное обращение к модели ради проверки статуса.
Другие потери нашлись в организации задач. План разросся до 550 мелких пунктов, из которых за сутки закрыли три. Сессий ревью оказалось 43 против 32 сессий разработки, а для исправлений часто запускали нового автора.
181 млн токенов и ни одной закрытой задачи
Одна сессия работала восемь часов, сделала 643 запроса и потратила 98 млн токенов. Соседняя задача прошла пять кругов "автор - ревью - исправление" в десяти сессиях. Вместе они потребовали 181 млн токенов и не дали ни одной закрытой задачи.
Этот цикл остановил инженер. Мы сохранили ветки с изменениями и отложили работу до готовности основного пути. Агент сам такого решения не принял.
Что мы изменили в управлении AI-агентами
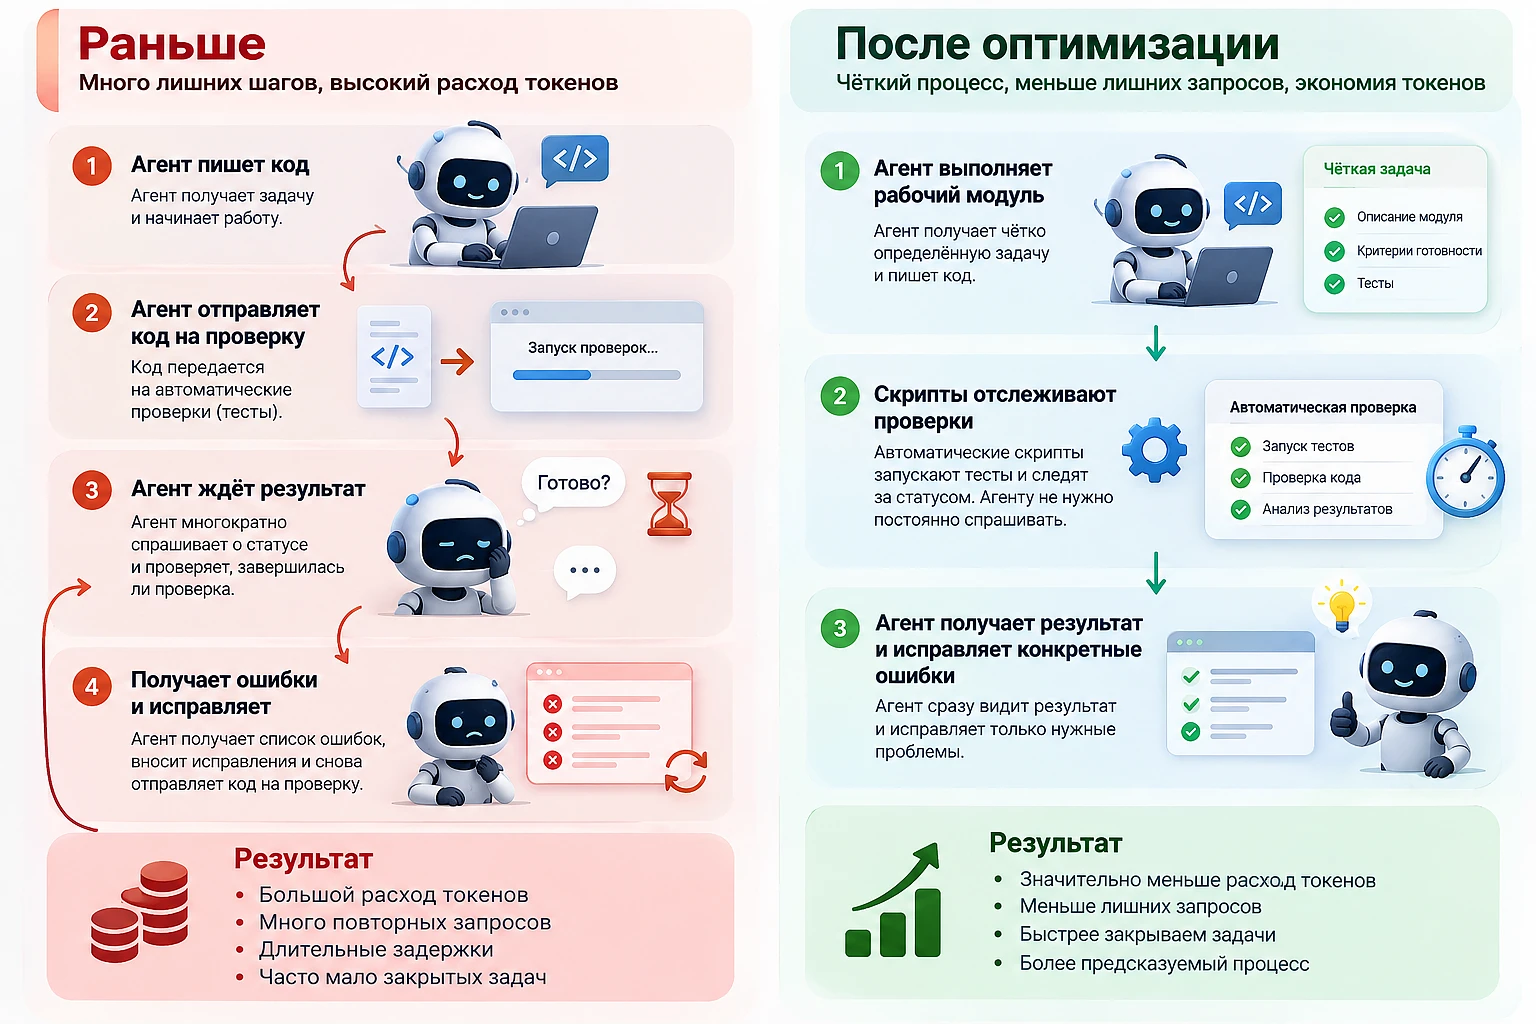
Мы передали скриптам повторяемые действия и укрупнили задачи до проверяемых модулей. Один автор стал вести модуль до слияния, а один ревьюер - проверять его и последующие исправления. Уровень модели начали явно задавать при выдаче работы.
Правило разделения простое: если действие выполняется по фиксированным правилам, а результат помещается в одну строку, его делает скрипт. Модели остаются разбор задачи, написание кода и поиск причин ошибки. Память координатора мы перенесли из длинного диалога в компактную таблицу в файле.
Ожидание стало одним вызовом скрипта, который отбрасывает служебные сигналы. На промежуточных шагах мы проверяем изменённые файлы. Полную проверку запускаем на готовом модуле параллельно с ревью, убирая из последовательного ожидания 15-23 минуты.
Было и стало
| Участок работы | Было | Стало |
|---|---|---|
| Координация | Модель опрашивает исполнителей и хранит состояние в диалоге | Скрипт ждёт содержательного сообщения, состояние хранится в файле |
| Задачи | Мелкие пункты, новый автор на очередное исправление | Проверяемый модуль, один автор до слияния |
| Скрипты | Выдача, сдача, приёмка и запуск проверок требуют цепочек обращений к модели | Каждая операция запускается одним вызовом |
| Тесты | Полная проверка стиля кода на каждом шаге, общая очередь проверок | Промежуточная проверка изменений, полная проверка перед сдачей, остановка при первой ошибке |
| Ревью | Повторные проверки всего модуля | Одна полная проверка, затем тот же ревьюер смотрит только исправления |
| Режим модели | Высокий уровень для всех авторов | Явное назначение уровня по риску задачи, без максимального режима |
Вместо 550 мелких задач мы выделили 20 модулей, каждый из которых можно запустить и проверить. Например, в проекте crm системы такой задачей мог бы стать полный путь согласования заявки. Для интернет-магазина - оформление заказа с проверкой оплаты.
На одном реальном изменении скрипт проверок автора выполнил работу за 49 секунд одним вызовом. Раньше запуск и сопровождение таких проверок занимали 10-30 обращений к модели. Это результат конкретного прогона, а не обещание времени для любой задачи.
У автоматизации есть своя цена. Скрипты потребовали отдельного PR и 45 тестов. Их нужно сопровождать, а ошибку в ожидании сообщений нельзя допустить: скрипт способен потерять важный ответ исполнителя.
Как мы назначаем уровень модели
Medium и High - уровни глубины рассуждений модели. Для сборки и настройки среды мы назначаем Medium. Для логики, связанной с деньгами и восстановлением после сбоя, используем High у автора и при полном ревью.
В наших журналах отдельные показатели расхода и времени шага на High были выше примерно на 30-60 %. Это не рост на порядки. Гораздо больше токенов съедали лишние обращения и повторные круги проверки.
Полное ревью на High 4,1 млн
Полное ревью на Medium 1,4 млн
Проверка только исправлений 0,5 млн
Источник: журналы Webdelo. Это расход токенов, а не денежная стоимость. Задачи на High и Medium различались.
Полное ревью на High 29 мин
Полное ревью на Medium 3 мин
Проверка только исправлений 2 мин
Источник: журналы Webdelo. Медиана показывает середину наблюдений: половина сессий была короче, половина длиннее.
Графики показывают расход разных видов проверки в нашем процессе. Они не доказывают, что Medium выполнит ту же работу быстрее. Повторная проверка только исправлений естественно короче полного разбора модуля.
На финансовой логике High оказался полезен: за двое суток ревью нашло три серьёзных дефекта. Один из них при работе системы привёл бы к повторному ордеру. Такие проверки мы сохранили.
Одной инструкции о выборе режима оказалось мало. Правило "обычный код на Medium" уже существовало, но координатор запустил всех 12 авторов на High. Это заметил инженер по журналам: у агента не было собственного учёта расхода.
Что показала оптимизация AI-разработки
За пять дней расход на слитый PR снизился с 50,3 до 22,6 млн входных токенов. В контрольных окнах темп слияния вырос с 0,75 до 1,6 PR в час. Это показатели процесса, а не цена одинакового объёма работы: после изменений PR стали крупнее.
5 октября 50,3
6 октября 37,6
7 октября 37,4
8 октября 35,1
9 октября 22,6
Источник: журналы Webdelo и история PR. За 9 октября учтены данные до 11:40 UTC. Размер PR менялся.
На графике виден устойчивый спад расхода на PR. При отдельном сравнении контрольных окон до и после изменений показатель снизился с 44 до 25 млн токенов, или на 43 %. Эти проценты относятся именно к контрольным окнам, а не к первой и последней точке графика.
После смены координатора за первые восемь часов закрыли 45 задач исходной нарезки против трёх за предыдущие сутки. Измеренный простой координатора сократился с 11,6 часа до нуля. В новых окнах не было пауз длиннее десяти минут, которые мы учитывали как простой.
Изменился и состав новых строк кода. Доля заглушек - автоматически созданных заготовок - резко снизилась. Больше места стали занимать тесты и продуктовый код, который выполняет операции системы.
Заглушки 39 %
Тесты 34 %
Продуктовый код 19,5 %
Прочее 7,5 %
Источник: изменения в репозитории Webdelo. Доли рассчитаны от 176 тыс. добавленных строк.
Заглушки 3 %
Тесты 47 %
Продуктовый код 42 %
Документация и прочее 8 %
Источник: изменения в репозитории Webdelo. Доли рассчитаны от 28,7 тыс. добавленных строк.
Диаграммы показывают, что работа сместилась от заготовок к поведению системы и его проверке. Число строк само по себе не измеряет качество кода.
Полностью проблему ожидания мы не решили. На 9 октября оно всё ещё занимало 71 % запросов координатора из-за ограничения инструмента в 300 секунд. Доля координатора в общем расходе оставалась около 30 %: процесс давал больше результатов, но структура расхода почти не изменилась.
Ограничения наших измерений
- PR разного размера. До изменений один PR обычно закрывал мелкую задачу, после - модуль в 1,5-3 тыс. строк.
- Medium и High получали разные задачи. Одну и ту же работу на двух уровнях мы не сравнивали.
- Качество после слияния не измерено. Мы не подсчитывали последующие дефекты и не доказали равенство качества разных режимов.
- Денежные затраты не посчитаны. Работа шла по лимитам подписки.
- Проект не завершён. На конец наблюдения выполнено около 65 % критериев спринта. Впереди денежная сверка и сценарии восстановления после сбоев.
Как токены влияют на стоимость разработки с ИИ
Токены связаны с реальными расходами через подписку и её лимиты либо оплату использования модели. Мы работали по лимитам подписки, поэтому экономию в долларах не измеряли. Лишние запросы приближают момент, когда работа остановится до обновления квоты или потребует дополнительных расходов.
В зависимости от сервиса оплата устроена через:
- платную подписку с ограничениями использования
- покупку дополнительных пакетов или квот
- API - программный доступ с оплатой потребления
Кэшированный вход при токенной тарификации может стоить меньше нового, но не становится бесплатным. В нашем учёте он также расходовал лимиты. Для Claude Code условия использования описаны в официальной справке Anthropic о моделях и лимитах.
В нашем процессе сокращение лишних обращений было важнее снижения уровня модели. Я ориентируюсь на затраты до принятого результата, включая повторы и неудачные проверки. Такой подход к оценке законченной задачи описан и в туториале на Хабре об экономии токенов.
Для бюджета продукта полезно разделять разработку и привлечение клиентов. Если корпоративный сайт связан с платформой, его доработки нужно учитывать отдельно от расходов на интернет маркетинг.
У сео продвижения сайтов и продвижения в Ai свои результаты и сроки измерения. Снижение токенов при написании кода не означает снижения всего бюджета цифрового продукта.
С нашей стороны оптимизация потребовала трёх разборов журналов за три дня и трёх документов с указаниями по 30-40 строк. Разборы выполнял агент по заданию инженера. Отдельно команда писала и проверяла скрипты, поэтому эти документы не отражают все трудозатраты на изменения.
Что нельзя оптимизировать ценой качества
Разработка платформ для алготрейдинга требует проверок финансовой логики и восстановления после сбоев. Мы сокращали повторяемую работу вокруг этих проверок. Сами сценарии, способные выявить потерю денег, остались обязательными.
Три ограничения предложил сам координатор в ответ на наши указания. Мы с ними согласились:
- Подтверждённый дефект нельзя скрыть ради ограничения числа кругов исправления.
- Проверки с реальной базой данных, аварийным остановом и финансовой сверкой выполняются обязательно.
- Первый неудачный результат проверки сохраняется в архиве. Его нельзя заменить успешным повторным прогоном.
Какие решения остались за инженером
Я считаю задачей модуль, который можно запустить и проверить. При прежнем темпе оставшиеся 343 мелкие задачи означали бы около 114 дней работы. Это была линейная оценка старого процесса, которая показала проблему в самой нарезке.
Мы отклонили предложение временно подключить к новому шлюзу только одну биржу. Выбрали полный путь для трёх бирж: переходный режим в финансовой системе легко становится постоянным. Это решение увеличило объём текущей работы.
Стратегию переносили с минимальными изменениями и сверочным прогоном. Переписывание "чище" добавило бы риск изменения её поведения. Здесь сохранение проверенной логики было важнее внешней аккуратности нового кода.
Инженеру нужно регулярно читать журналы и корректировать правила. В нашем случае ежедневная проверка помогала замечать возвращение лишних действий. Инструкция для агента сама по себе не обеспечивала соблюдение процесса.
Если вы хотите оптимизировать существующую AI-разработку, создать корпоративную платформу или организовать поддержку сложного ПО, обсудите задачу с Webdelo. Начать стоит с текущего процесса и критериев приёмки.
Что я вынес из этого спринта
Главные потери в нашем кейсе создавала организация работы агентов. Журналы помогли найти лишнее ожидание, а скрипты и укрупнение задач сократили повторные обращения к модели. Проверки финансовых рисков мы сохранили.
Тот же принцип применим к B2B-платформам, FinTech и ERP: сначала измерить процесс, затем автоматизировать рутину и закрепить ответственность за результат. Корпоративная разработка ПО с агентами требует инженерных решений на каждом из этих шагов.
Часто задаваемые вопросы
Что такое AI-first разработка простыми словами?
Это подход, при котором код пишут AI-агенты, а инженеры управляют работой и принимают результат. В Webdelo агент-координатор распределял задачи между тремя-четырьмя авторами кода, агенты-ревьюеры проверяли изменения, а люди принимали архитектурные решения. Быстрый прототип при этом не равен надёжной системе: там, где система работает с деньгами, независимая проверка кода и тесты остаются обязательными.
Почему AI-агенты расходуют так много токенов?
Основной расход создаёт не написание кода, а повторная отправка накопленной истории работы. В кейсе Webdelo за пять дней набралось 3,25 млрд входных токенов, из них 97,4 % составлял кэшированный контекст, то есть уже переданная информация. Около 59 % входных токенов ушло на ожидание: агент спрашивал, прошли ли тесты, и каждый такой вопрос снова передавал модели весь контекст. Расход считается просто: число запросов, умноженное на средний размер контекста.
Как сократить расход токенов при разработке с AI-агентами?
В Webdelo повторяемые действия передали скриптам: ожидание, выдачу и сдачу задач, запуск проверок. Вместо 550 мелких задач выделили 20 модулей, которые можно запустить и проверить, и закрепили за каждым одного автора и одного ревьюера. Уровень модели стали назначать по риску задачи. За пять дней расход на слитый PR снизился с 50,3 до 22,6 млн входных токенов, а темп вырос с 0,75 до 1,6 PR в час, но PR при этом стали крупнее, поэтому это показатели процесса, а не цена одинаковой работы.
Как токены влияют на стоимость разработки с ИИ?
Токены связаны с реальными расходами через платную подписку с лимитами, покупку дополнительных пакетов или квот либо оплату через API по потреблению. Лишние запросы приближают момент, когда работа остановится до обновления квоты или потребует доплаты. Кэшированный вход может стоить меньше нового, но бесплатным не становится. Webdelo работала по лимитам подписки, поэтому экономию в долларах команда не измеряла.
Что нельзя сокращать при оптимизации AI-разработки?
Нельзя убирать проверки финансовой логики и восстановления после сбоев. В Webdelo сокращали повторяемую работу вокруг этих проверок, но сами проверки с реальной базой данных, аварийным остановом и финансовой сверкой остались обязательными. Подтверждённый дефект нельзя скрыть ради меньшего числа кругов исправления, а первый неудачный результат проверки сохраняется в архиве. За двое суток такое ревью нашло три серьёзных дефекта, один из которых привёл бы к повторному ордеру.
Почему при работе с AI-агентами всё равно нужен инженер?
Агент не ведёт собственный учёт расхода и не всегда соблюдает инструкции. В кейсе Webdelo две задачи потратили 181 млн токенов и не были закрыты, и этот цикл остановил инженер, а не агент. Координатор запустил всех 12 авторов на высоком уровне модели, хотя правило требовало другого, и это тоже заметил человек по журналам. Поэтому инженеру нужно регулярно читать журналы, корректировать правила и принимать решения о нарезке задач и архитектуре.
Насколько можно доверять этим цифрам и какие у них ограничения?
Цифры взяты из журналов агентов и истории PR за пять дней, но у измерений есть ограничения. PR были разного размера: до изменений один PR закрывал мелкую задачу, после - модуль в 1,5-3 тыс. строк. Уровни Medium и High не сравнивали на одной и той же задаче, дефекты после слияния и денежные затраты не считали. Проект не завершён: на конец наблюдения выполнено около 65 % критериев спринта.
